

Nous lançons aujourd'hui Altar, notre premier modèle de sécurité aux poids ouverts, conçu pour intégrer une sécurité défensive de pointe au cœur de l'infrastructure que vous contrôlez.
Nous avons franchi une première étape vers une veille de sécurité souveraine avec notre appareil de pentest autonome Aikido Machine, qui s'exécute entièrement au sein de la propre infrastructure du client, y compris dans des environnements totalement cloisonnés (air-gapped). Les équipes soumises à des règles strictes en matière de confidentialité du code peuvent détecter, exploiter et valider en continu les vulnérabilités de leur surface d'attaque sans enfreindre ces règles.
Altar dote Aikido Machine d'une IA avancée capable de se défendre sans transmettre le contexte le plus sensible d'une organisation à un service d'inférence tiers.
Pour y parvenir, nous devions combler le fossé du déploiement. La plupart des modèles performants aux poids ouverts restent difficiles à déployer à l'échelle de la production tout en conservant la qualité de raisonnement des modèles de pointe.
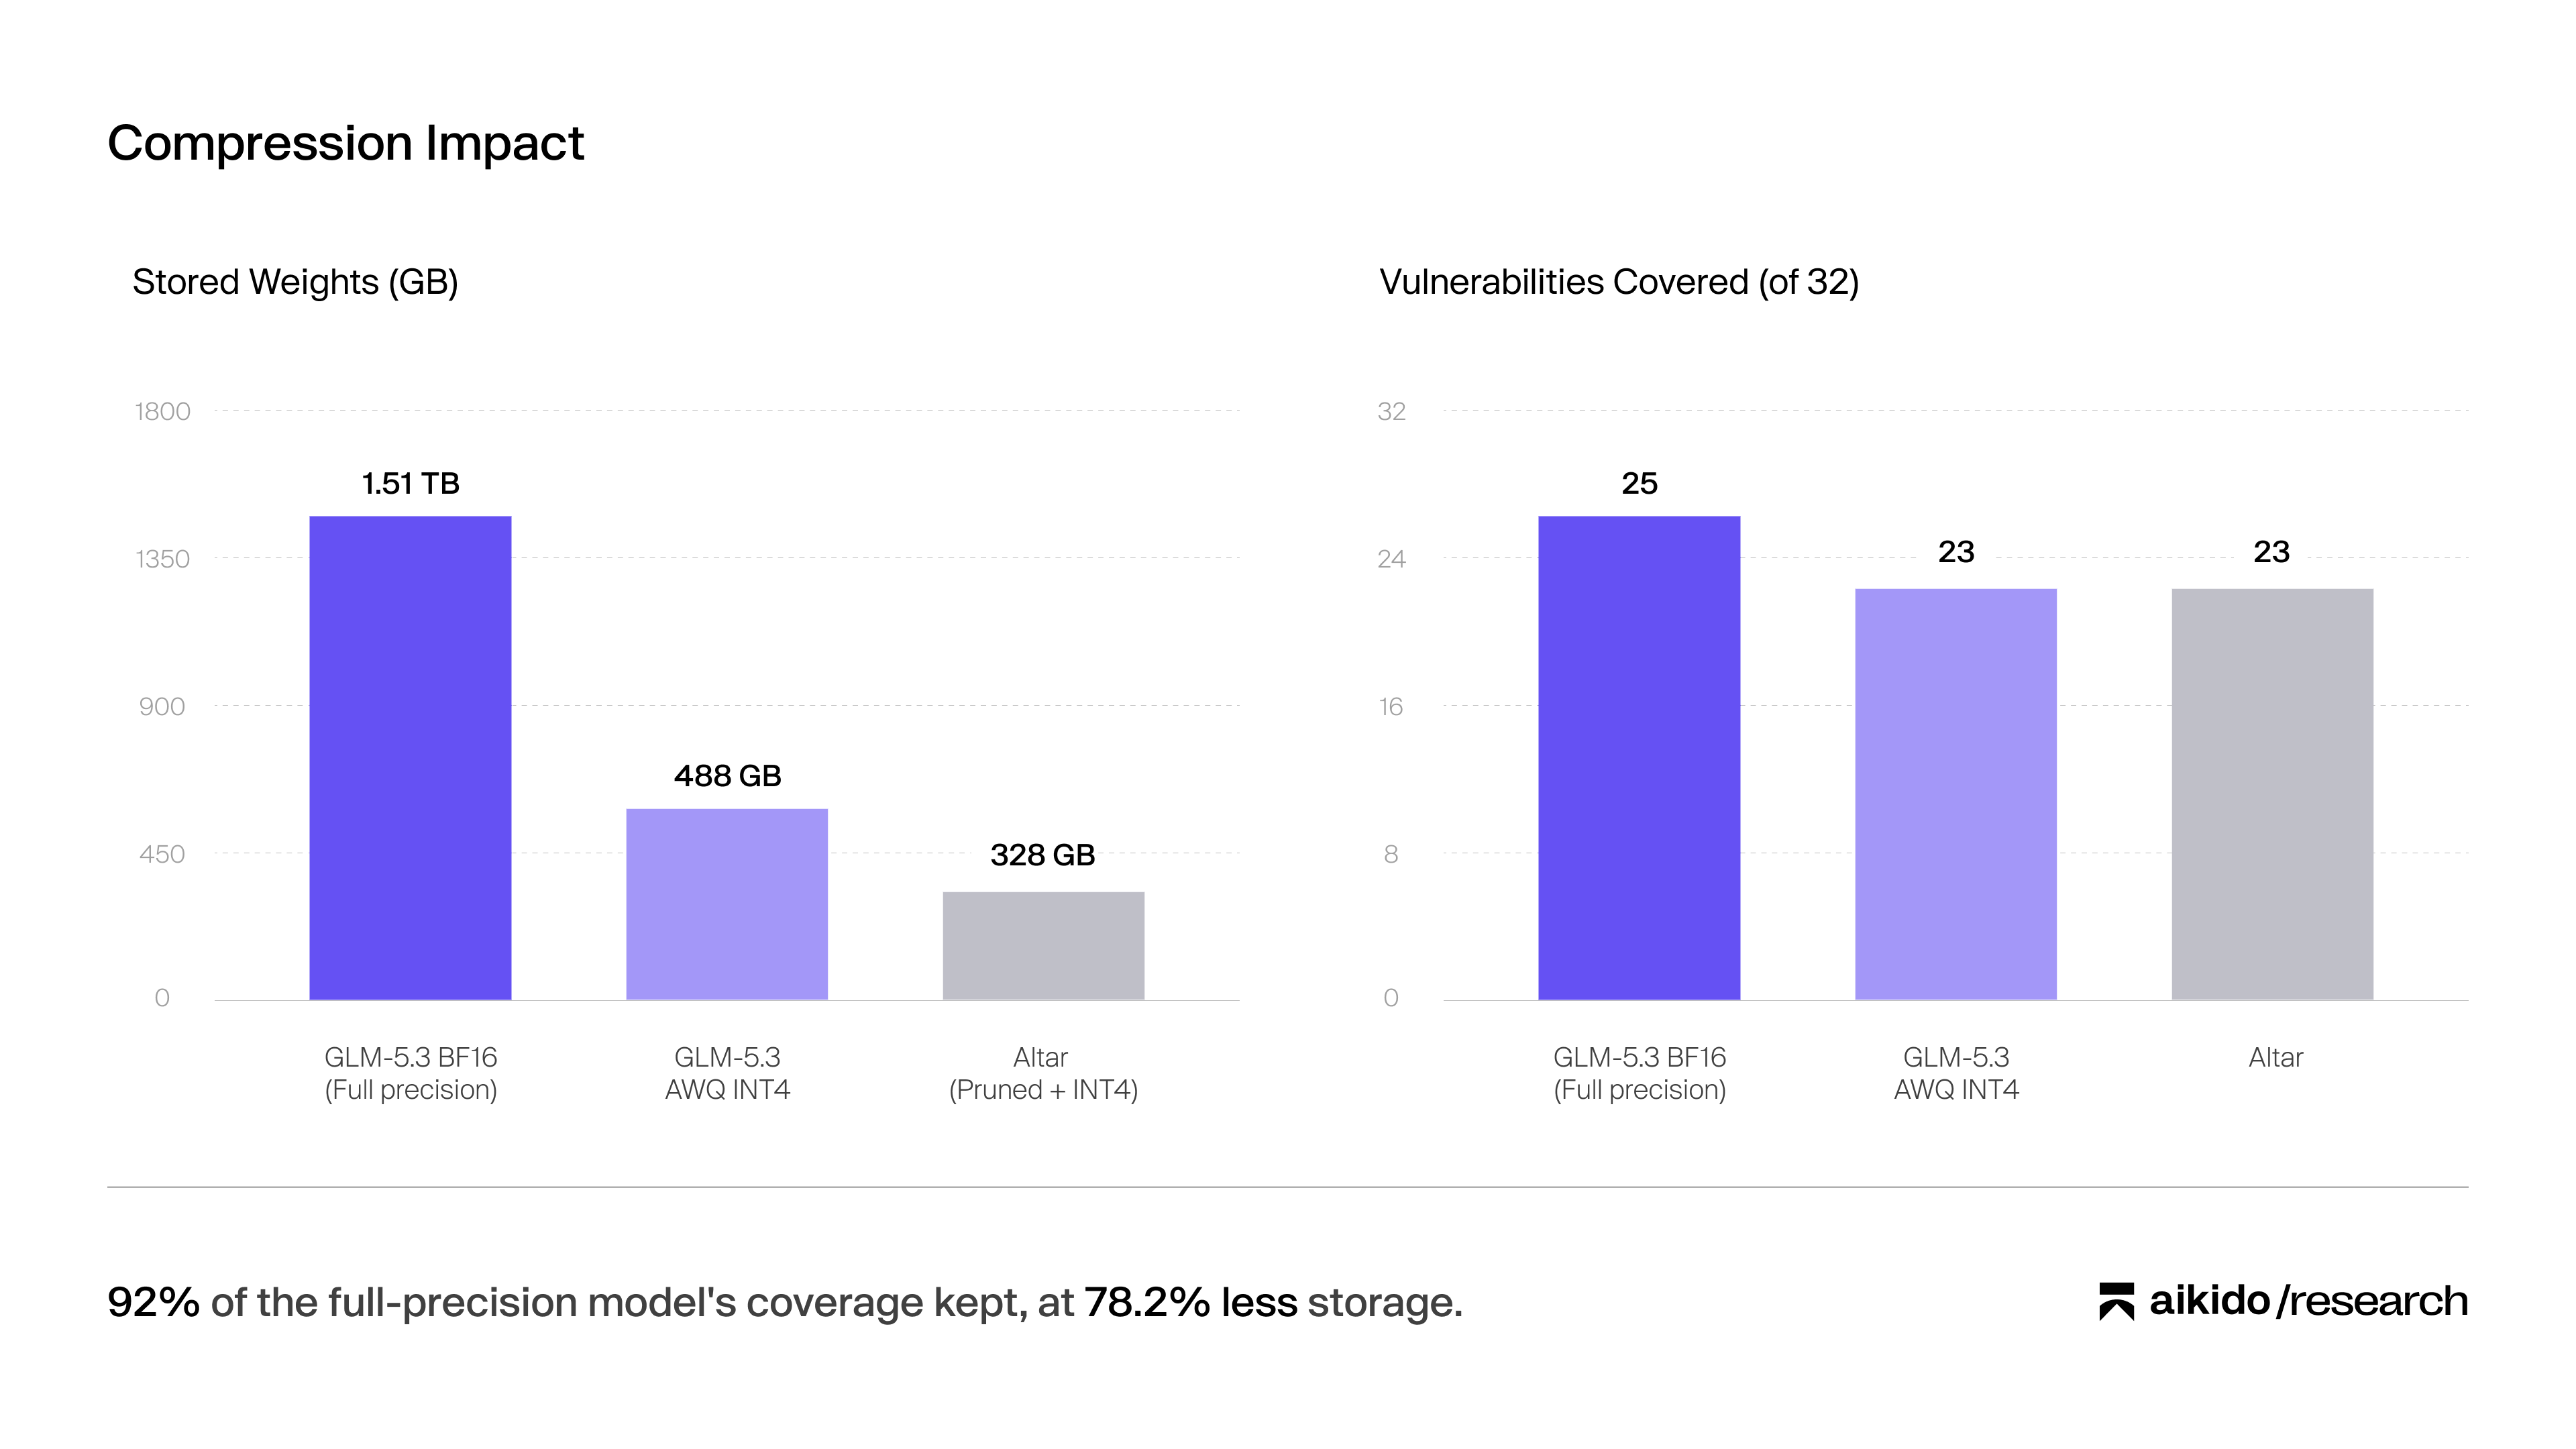
Nous avons commencé par GLM-5.3, l'un des modèles les plus robustes de nos évaluations de sécurité. Le modèle complet pèse 1,51 To ; la quantification réduit ce poids à 488 Go, et notre processus d'élagage d'experts le ramène encore à 328 Go, tout en préservant l'essentiel des capacités de raisonnement du modèle d'origine.
Le fossé entre modèles de pointe et modèles aux poids ouverts expliqué
Les modèles de pointe fermés s'exécutent sur l'infrastructure d'un tiers
L'utilisation de l'un de ces modèles implique que votre code source, votre documentation d'architecture interne et vos résultats non corrigés quittent votre réseau. Pour une banque soumise à une obligation de résidence des données, un groupe hospitalier soumis à des règles strictes de traitement des données, ou un opérateur industriel dont l'environnement OT n'a aucun accès à Internet, c'est un compromis inacceptable.
Le fossé du déploiement
Héberger un modèle tel que GLM 5.3 en pleine précision nécessite des centaines de gigaoctets de mémoire unifiée et offre une vitesse d'inférence limitée lors du traitement de conversations parallèles avec de grandes fenêtres de contexte. En clair, ils sont gigantesques.
Ces besoins en ressources s'expliquent en partie par la conception de ces modèles. Nombre des modèles les plus puissants aujourd'hui utilisent des architectures de type mélange d'experts (Mixture-of-Experts). Ces modèles sont constitués d'une multitude de petits réseaux de neurones spécialisés, chacun appelé un expert. Seul un petit nombre d'experts est actif pour chaque jeton (token), tandis que l'ensemble du pool d'experts doit tout de même être stocké et hébergé. Cela se traduit par un coût important en matière de mémoire et d'infrastructure pour une capacité qui ne contribue que très peu à la charge de travail réellement exécutée.
Les tâches de sécurité, telles que l'examen du code à la recherche de vulnérabilités, la proposition de correctifs et l'exécution d'un test d'intrusion, ne sollicitent qu'une infime partie de ce pool d'experts. Pourtant, le coût en mémoire ne diminue pas en proportion : chaque requête doit tout de même charger le modèle complet, qu'il soit ou non pertinent pour la tâche.
Si l'on ajoute des agents à l'équation, l'utilisation du contexte explose, ce qui sature la mémoire et amène les agents à se disputer l'espace disponible. Chacun conserve un historique de tout ce qu'il a vu et fait, et cet enregistrement réside dans la mémoire du GPU aux côtés du modèle lui-même, grossissant à mesure que l'analyse se poursuit et se multipliant pour chaque analyse exécutée en parallèle.
C'est pourquoi la taille du modèle compte ici : le modèle et tout ce contexte en expansion puisent dans la même réserve de mémoire fixe, de sorte que l'emprise de l'un réduit d'autant l'espace disponible pour l'autre. L'objectif est de rendre un modèle de pointe plus efficace à exploiter pour une charge de travail spécifique, en préservant les fonctionnalités essentielles tout en libérant de la capacité pour tout ce qui s'exécute en parallèle.
Que pouvons-nous supprimer sans perdre l'essentiel ?
La lourde charge que représente l'emport d'un si grand nombre d'experts dans un modèle peut être transformée en avantage grâce aux bonnes techniques. Afin de minimiser la taille des modèles aux poids ouverts dans un contexte de sécurité basé sur des agents tout en maintenant une haute précision, nous avons eu recours à la quantification et à l'élagage.
L'élagage d'experts supprime certains experts du modèle, généralement en effaçant des blocs entiers de poids d'experts et en ajustant le modèle pour que chaque jeton (token) ne choisisse que parmi ceux qui restent. La suppression en soi est mécanique. Décider quels experts supprimer est la partie la plus difficile, et la perte peut être inégale : un modèle plus performant sur le plan du code peut conserver de bons résultats tout en perdant une grande partie de sa capacité à comprendre une langue naturelle particulière. Il risque alors de ne plus être en mesure d'interpréter de manière fiable la documentation, les règles métier ou les fonctionnalités d'une application décrites dans cette langue.
Pour décider ce qu'il convenait de conserver, nous sommes partis de la donnée la plus naturelle : les traces issues de notre outil de pentest exécutant des benchmarks internes. Celles-ci consignent le code, les appels d'outils et les réponses manipulés par les agents lors d'un test d'intrusion complet, ce qui nous fournit des entrées représentatives pour guider la sélection des experts. Aucune donnée client n'a jamais été impliquée.
Cette étape de calibration nous offre une base spécifique à la charge de travail pour la sélection des experts, sans avoir à entraîner de nouvelles compétences dans le modèle.
Les traces de l'outil couvraient la charge de travail technique. Nous devions également préserver la compréhension du langage : analyser une application implique de comprendre ses fonctionnalités, ses règles métier et ses flux de travail prévus, y compris lorsque sa documentation ou son interface est en français, en néerlandais ou dans une autre langue. Nous avons par conséquent ajouté du texte multilingue pour contribuer à préserver ces capacités lors de l'élagage.
La sélection compte autant que la taille
Il existe de nombreuses techniques d'élagage pour réduire l'empreinte des LLM, nous avons donc choisi une approche capable de préserver les performances pour nos cas d'usage : Cerebras REAP, pour Router-weighted Expert Activation Pruning (élagage d'activation d'experts pondéré par le routeur). Nous avons utilisé le score de contribution de REAP avec une stratégie d'agrégation préservant le domaine, sélectionnée à travers des tests de fidélité. Compter la fréquence de sélection d'un expert ne donne qu'une vision partielle. REAP estime sa contribution en s'appuyant à la fois sur la pondération du routeur et sur l'amplitude de la sortie de l'expert.
Nous examinons également les contributions à travers différents groupes d'exemples. Sans cela, une capacité essentielle pour une charge de travail moins courante risque d'être gommée dans une moyenne globale. Les compétences en cybersécurité, en codage et en langage sont réparties entre les différents experts ; il n'existe pas de groupe clairement étiqueté d'« experts en cybersécurité » à conserver ou à écarter.
Dans l'étude de compression justificative, les modèles conservant le même nombre d'experts présentaient des différences substantielles quant à la fidélité de leurs sorties par rapport au modèle de référence. La taille seule ne suffisait pas à déterminer ce qui était conservé.
De 1,51 To à 328 Go
Nous avons obtenu une réduction totale de la taille du modèle de 78,2 % par rapport à GLM 5.3 en pleine précision, et de 32,8 % par rapport à GLM 5.3 avec une quantification AWQ INT4. Altar conserve 168 des 256 experts routés d'origine dans chaque couche d'experts du backbone, en supprimant 88, soit 34,4 % d'entre eux. Le routeur sélectionne toujours huit experts par jeton, cette fois parmi le banc réduit.
L'autre partie de la réduction provient de la quantification. Les poids d'un modèle correspondent aux valeurs numériques apprises lors de l'entraînement. La quantification stocke ces nombres avec un nombre de bits inférieur, sacrifiant un peu de précision au profit de poids stockés plus légers. Contrairement à l'élagage (pruning), elle ne supprime pas d'experts.
Notre point de contrôle initial utilisait AWQ pour stocker la plupart des poids d'experts sur quatre bits au lieu des seize du modèle BF16. AWQ exploite des informations sur l'activité du modèle lors d'entrées d'exemple afin de limiter les erreurs induites par une plus faible précision. Les valeurs intermédiaires générées lors de l'inférence, appelées activations, restent sur 16 bits : d'où la désignation W4A16, soit des poids sur quatre bits et des activations sur 16 bits. Certains poids conservent également une précision supérieure. Nous avons ensuite appliqué l'élagage à ce point de contrôle déjà quantifié.
La comparaison des deux représentations parentes montre la contribution de chaque étape :
Cela représente 78,2 % de stockage en moins par rapport au modèle complet sur 16 bits. Par rapport au modèle parent déjà quantifié, l'élagage supprime 160 Go supplémentaires, soit une réduction de 32,8 %.
L'impact de la compression sur les capacités d'identification des vulnérabilités
Nous avons préalablement développé un référentiel CVE interne que nous utilisons pour évaluer la capacité d'un modèle à identifier des vulnérabilités complexes du monde réel grâce à notre outil d'analyse de code par IA : 32 vulnérabilités connues réparties sur 30 dépôts, avec trois exécutions par cas.
Nous avons soumis Altar à ce test. Altar a atteint une moyenne de 60,4 % de taux de rappel par exécution et a redécouvert 23 des 32 vulnérabilités au moins une fois sur les trois exécutions.
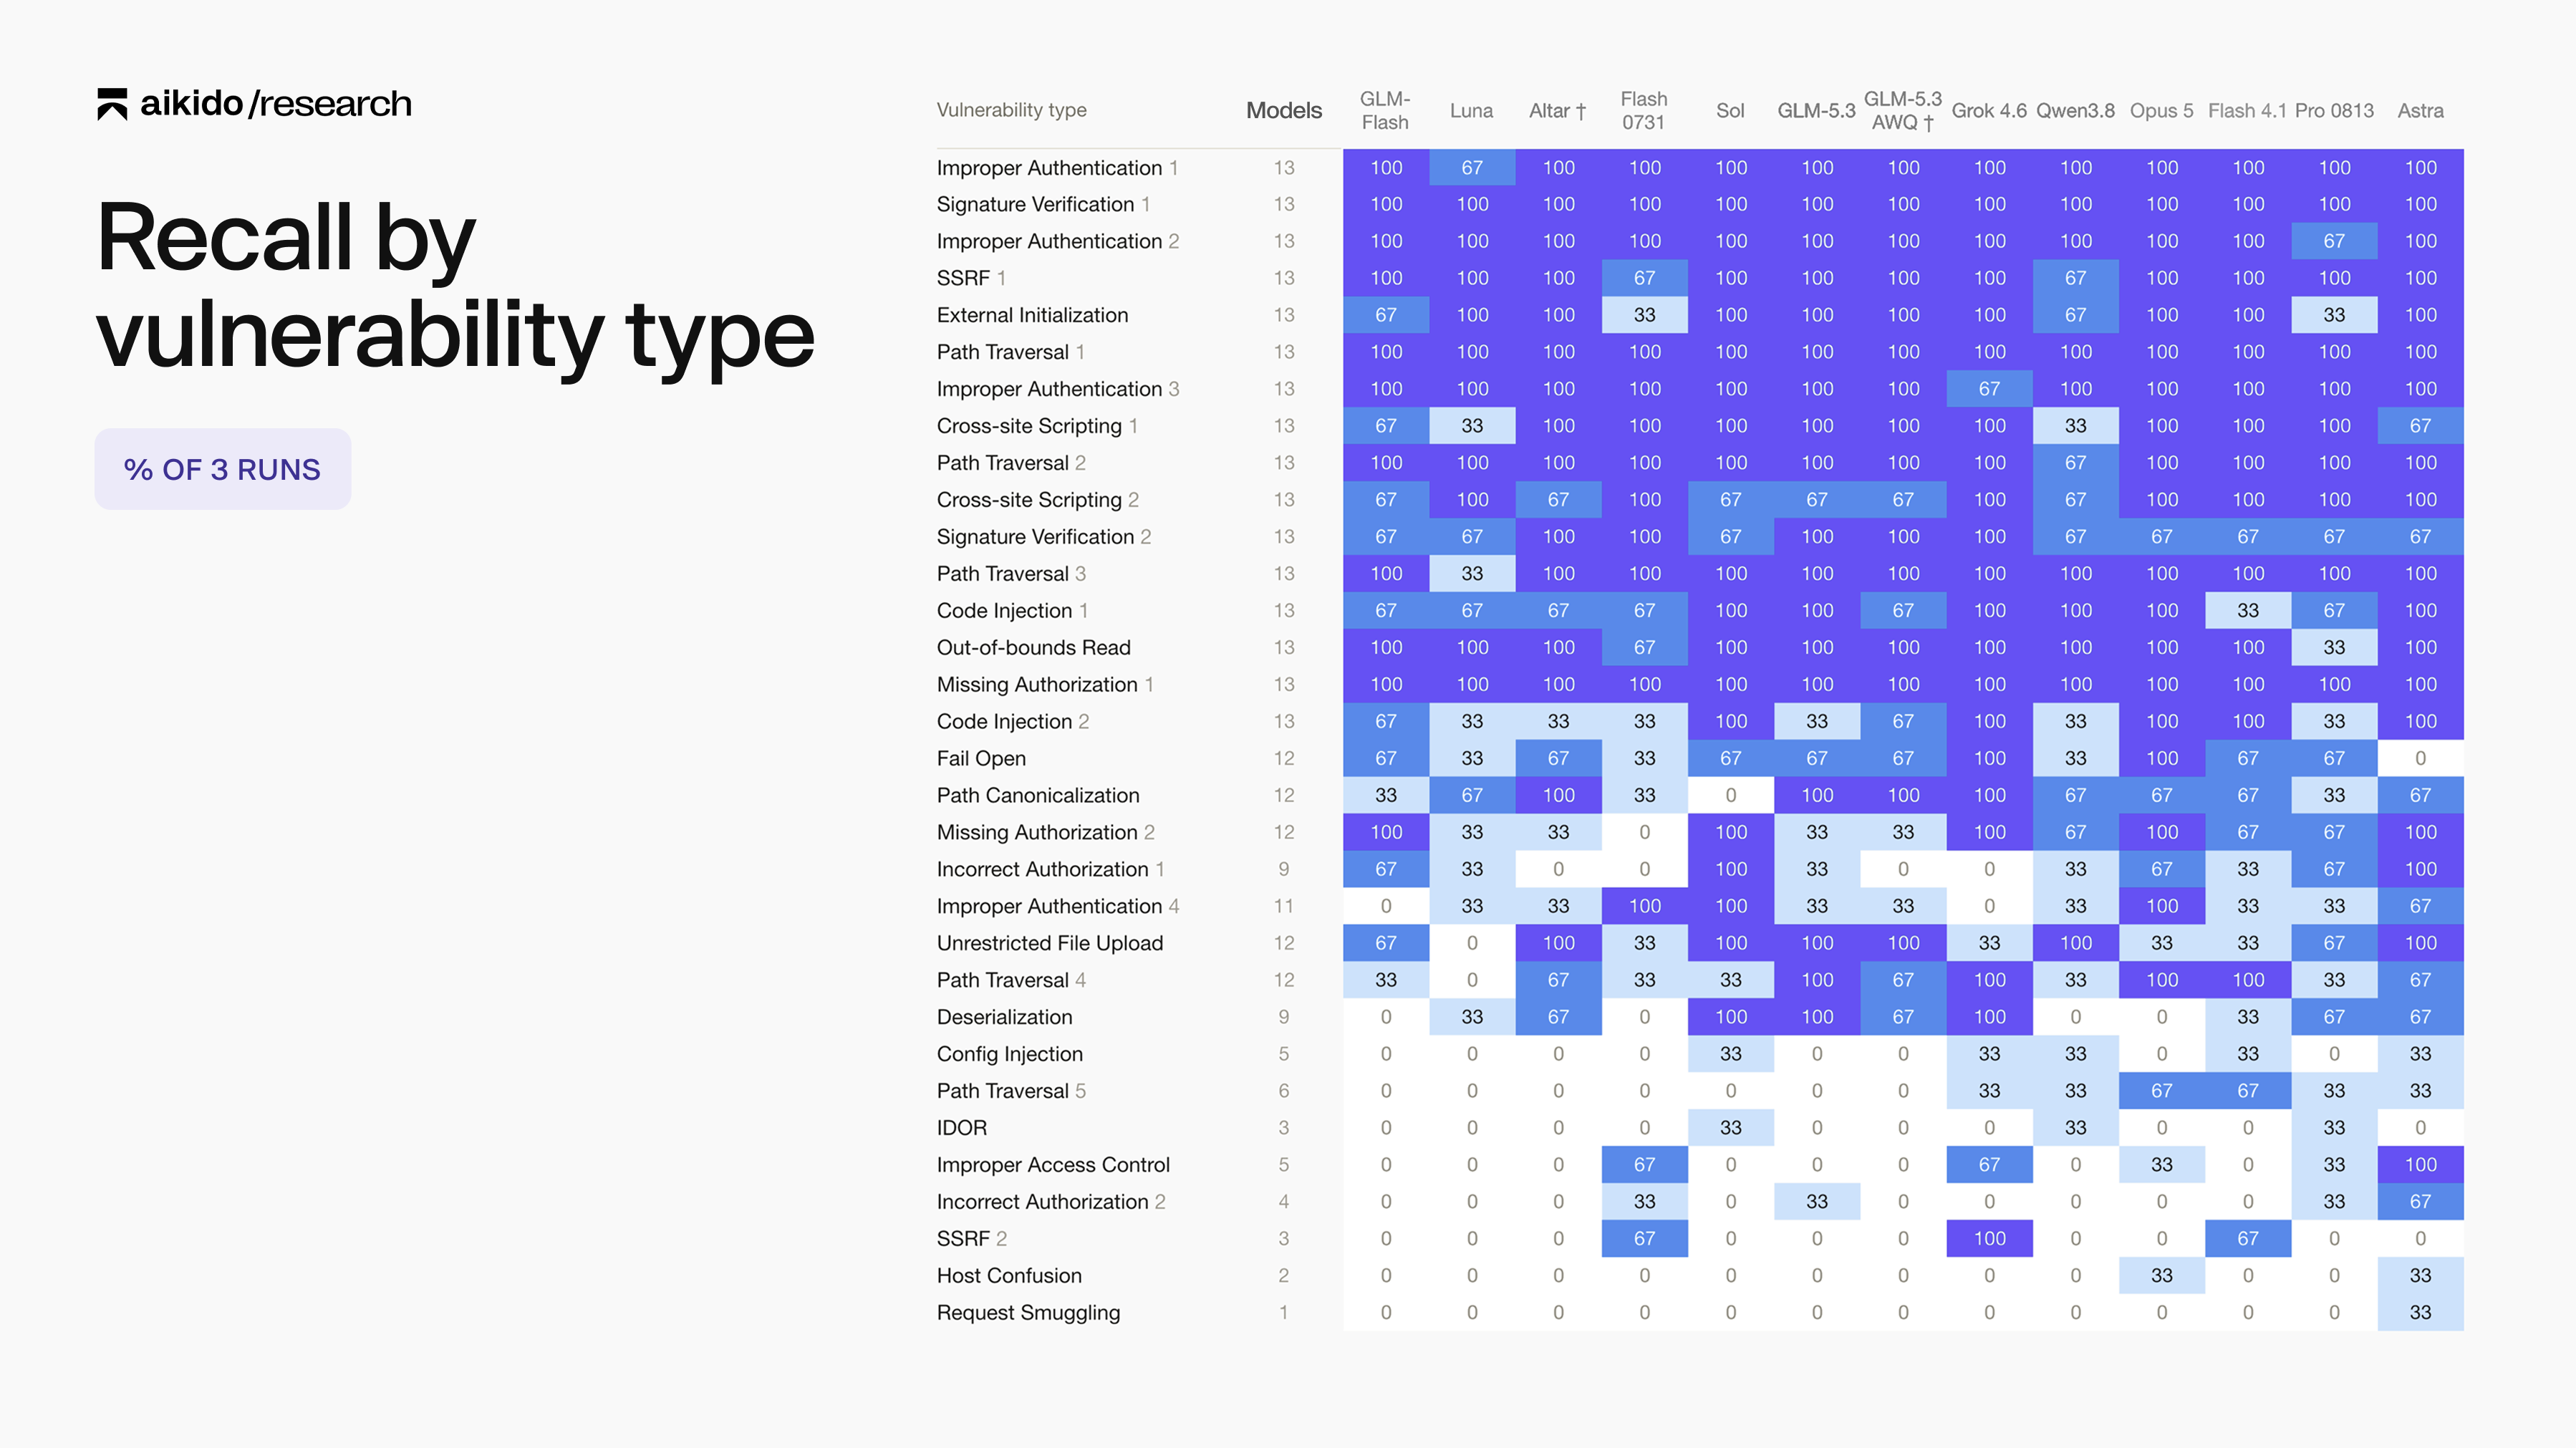
En comparaison, le modèle quantifié GLM-5.3 AWQ a affiché une moyenne de 61,5 % de rappel et a couvert les mêmes 23 vulnérabilités. Le modèle original GLM-5.3 en pleine précision a obtenu une moyenne de 65,6 % de rappel et a couvert 25 vulnérabilités sur 32.
En d'autres termes, la réduction du point de contrôle déjà quantifié, passant de 488 Go à 328 Go (soit une diminution de 32,8 % des poids stockés), a entraîné une baisse d'environ un point de pourcentage du rappel moyen par rapport à la référence AWQ, tout en conservant l'intégralité de sa couverture des vulnérabilités. Par rapport au parent d'origine, Altar a conservé 23 des 25 vulnérabilités couvertes, soit 92 %, avec une baisse de 5,2 points de pourcentage du rappel moyen. Cela représente 92 % de la couverture des vulnérabilités du parent pour un volume de stockage réduit de 33 %.
C'est précisément le compromis que nous recherchions : un modèle nettement plus compact tout en préservant l'essentiel des capacités de sécurité du parent.
Nous présentons le rappel moyen par exécution séparément de la couverture sur trois exécutions : identifier une vulnérabilité une seule fois diffère de sa détection de manière cohérente. Les exécutions terminées sans découverte sont comptabilisées comme des échecs ; les exécutions incomplètes sont rapportées séparément.
Cette mesure évalue la redécouverte ciblée de CVE au sein d'un pipeline qui utilise d'autres modèles pour les étapes environnantes. Elle ne mesure pas la découverte à l'aveugle sur l'ensemble d'une base de code, n'exécute pas d'exploits pour valider les résultats et n'évalue pas l'étape de proposition de correctifs. Ces limites permettent de distinguer ce benchmark du workflow de pentest plus large qu'Altar est conçu pour assister.
De plus, nous avons déployé Altar sur notre parc de machines Aikido immédiatement après la fin de ces évaluations. Peu après son déploiement, il a identifié une vulnérabilité critique valide lors d'un test d'intrusion en production chez un client.
{{cta}}
Et ensuite ?
L'idée sous-jacente est plus vaste : l'intelligence en matière de sécurité souveraine doit s'exécuter au sein même de l'environnement qu'elle protège.
Altar n'est qu'un début. Concernant la compression, nous explorons des formats à plus faible nombre de bits tels que EXL3, qui pourraient nous permettre de conserver un plus grand nombre d'experts, parallèlement à de nouvelles optimisations de service pour les H200.
L'étape suivante consiste à aller au-delà de la compression pour aborder l'entraînement : affiner les modèles pour les workflows de sécurité, améliorer l'utilisation des outils et le raisonnement à long terme, et bâtir un pipeline d'auto-apprentissage alimenté par nos benchmarks internes pour guider et façonner les futurs modèles.
Ce travail s'étendra à la recherche sur les vulnérabilités, à l'analyse de code, à la remédiation et à d'autres workflows de sécurité défensive.
Aikido Labs a pour vocation de repousser ces limites : des modèles qui gagnent en performance au fil du temps sans perdre la contrainte essentielle, à savoir que les équipes de défense doivent pouvoir les exécuter entièrement au sein des environnements dont elles ont la charge de protéger.
Merci à Z.AI pour GLM-5.3, à Cerebras pour REAP, à cyanwiki pour le modèle quantifié et à 0xSero pour le travail de compression. L'étude de fidélité publique et les plans de conservation ainsi que la boîte à outils d'élagage fournissent davantage de détails techniques, sans publier les conversations brutes des agents.
Les poids d'Altar sont disponibles au sein de l'organisation Aikido. Altar peut être déployé et exploité aisément à l'aide d'un nœud équipé de 4 cartes H200 et de la dernière version de vLLM. Téléchargez Altar pour consulter la fiche du modèle, la licence, les indicateurs d'exécution et les instructions de déploiement.
Besoin d'aide pour l'exécuter dans votre propre environnement ? Contactez l'équipe commerciale pour échanger sur le déploiement d'Altar en local (on-prem).
Cette approche s'étend à l'ensemble de la gamme de produits d'Aikido, notamment Aikido Attack (pentest IA), Code Security Audit et Deep PR Review.




