Nous avons détruit 11,7 milliards de jetons pour trouver le meilleur modèle d'IA cybernétique
GLM5.3 et DeepSeek sont désormais des modèles de pointe
Vous souhaitez consulter les derniers benchmarks ? Découvrez Aikido Arena, que nous mettons régulièrement à jour.
Nous avons consommé 11,7 milliards de jetons pour évaluer les capacités en cybersécurité de 10 modèles d'IA avec trois essais chacun, face à 32 vulnérabilités prêtes à l'emploi à redécouvrir.
Ce benchmark est une évolution de notre précédent benchmark basé sur les CVE connues, avec un jeu de données inédit et plus complexe, davantage de modèles et une analyse plus fine de ce qu'ils détectent, de la régularité de leurs découvertes, ainsi que de leurs particularités et compromis.
Nous ajoutons ainsi GLM-5.3, DeepSeek V4 Pro 0813, DeepSeek V4 Flash 0731, Qwen3.8-Max, Kimi K3 et Grok 4.6 à notre sélection.
TL;DR :
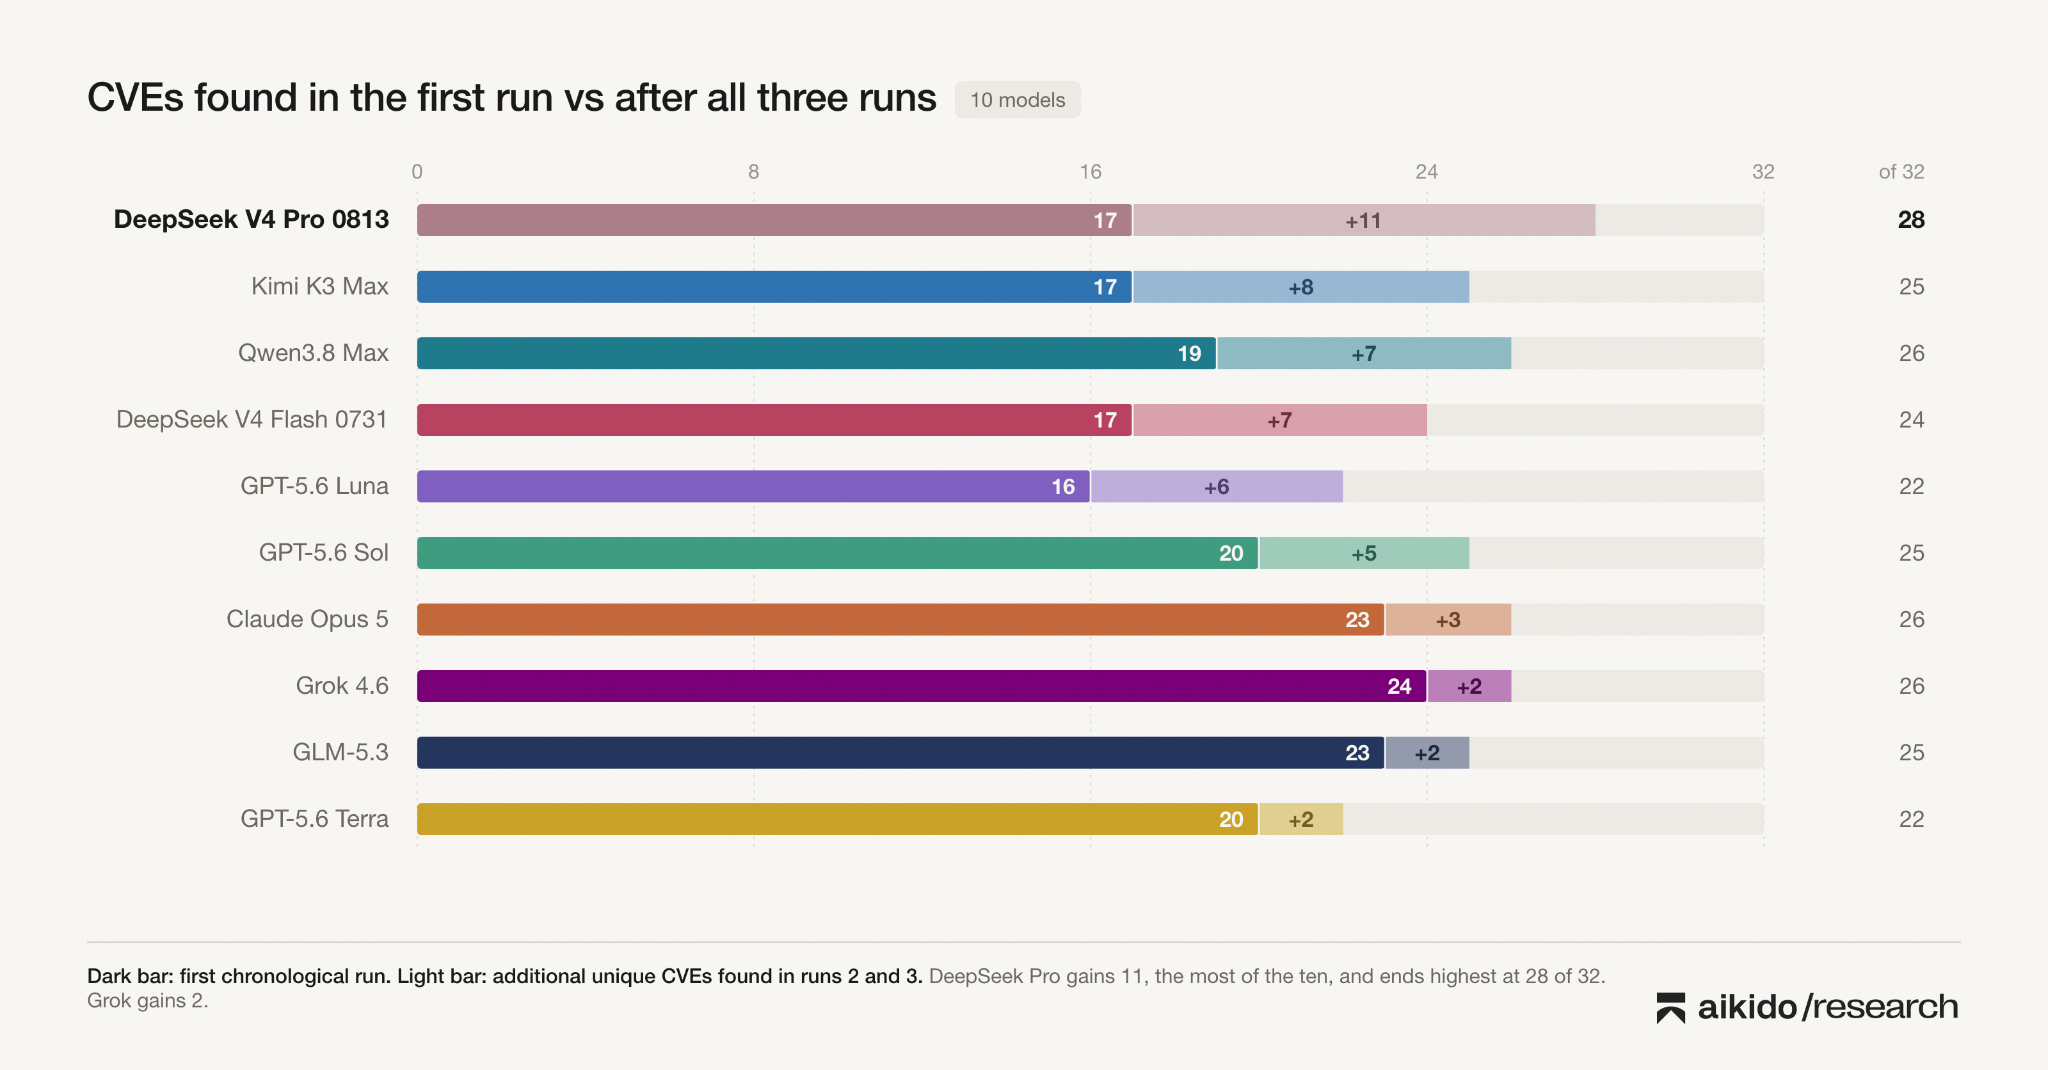
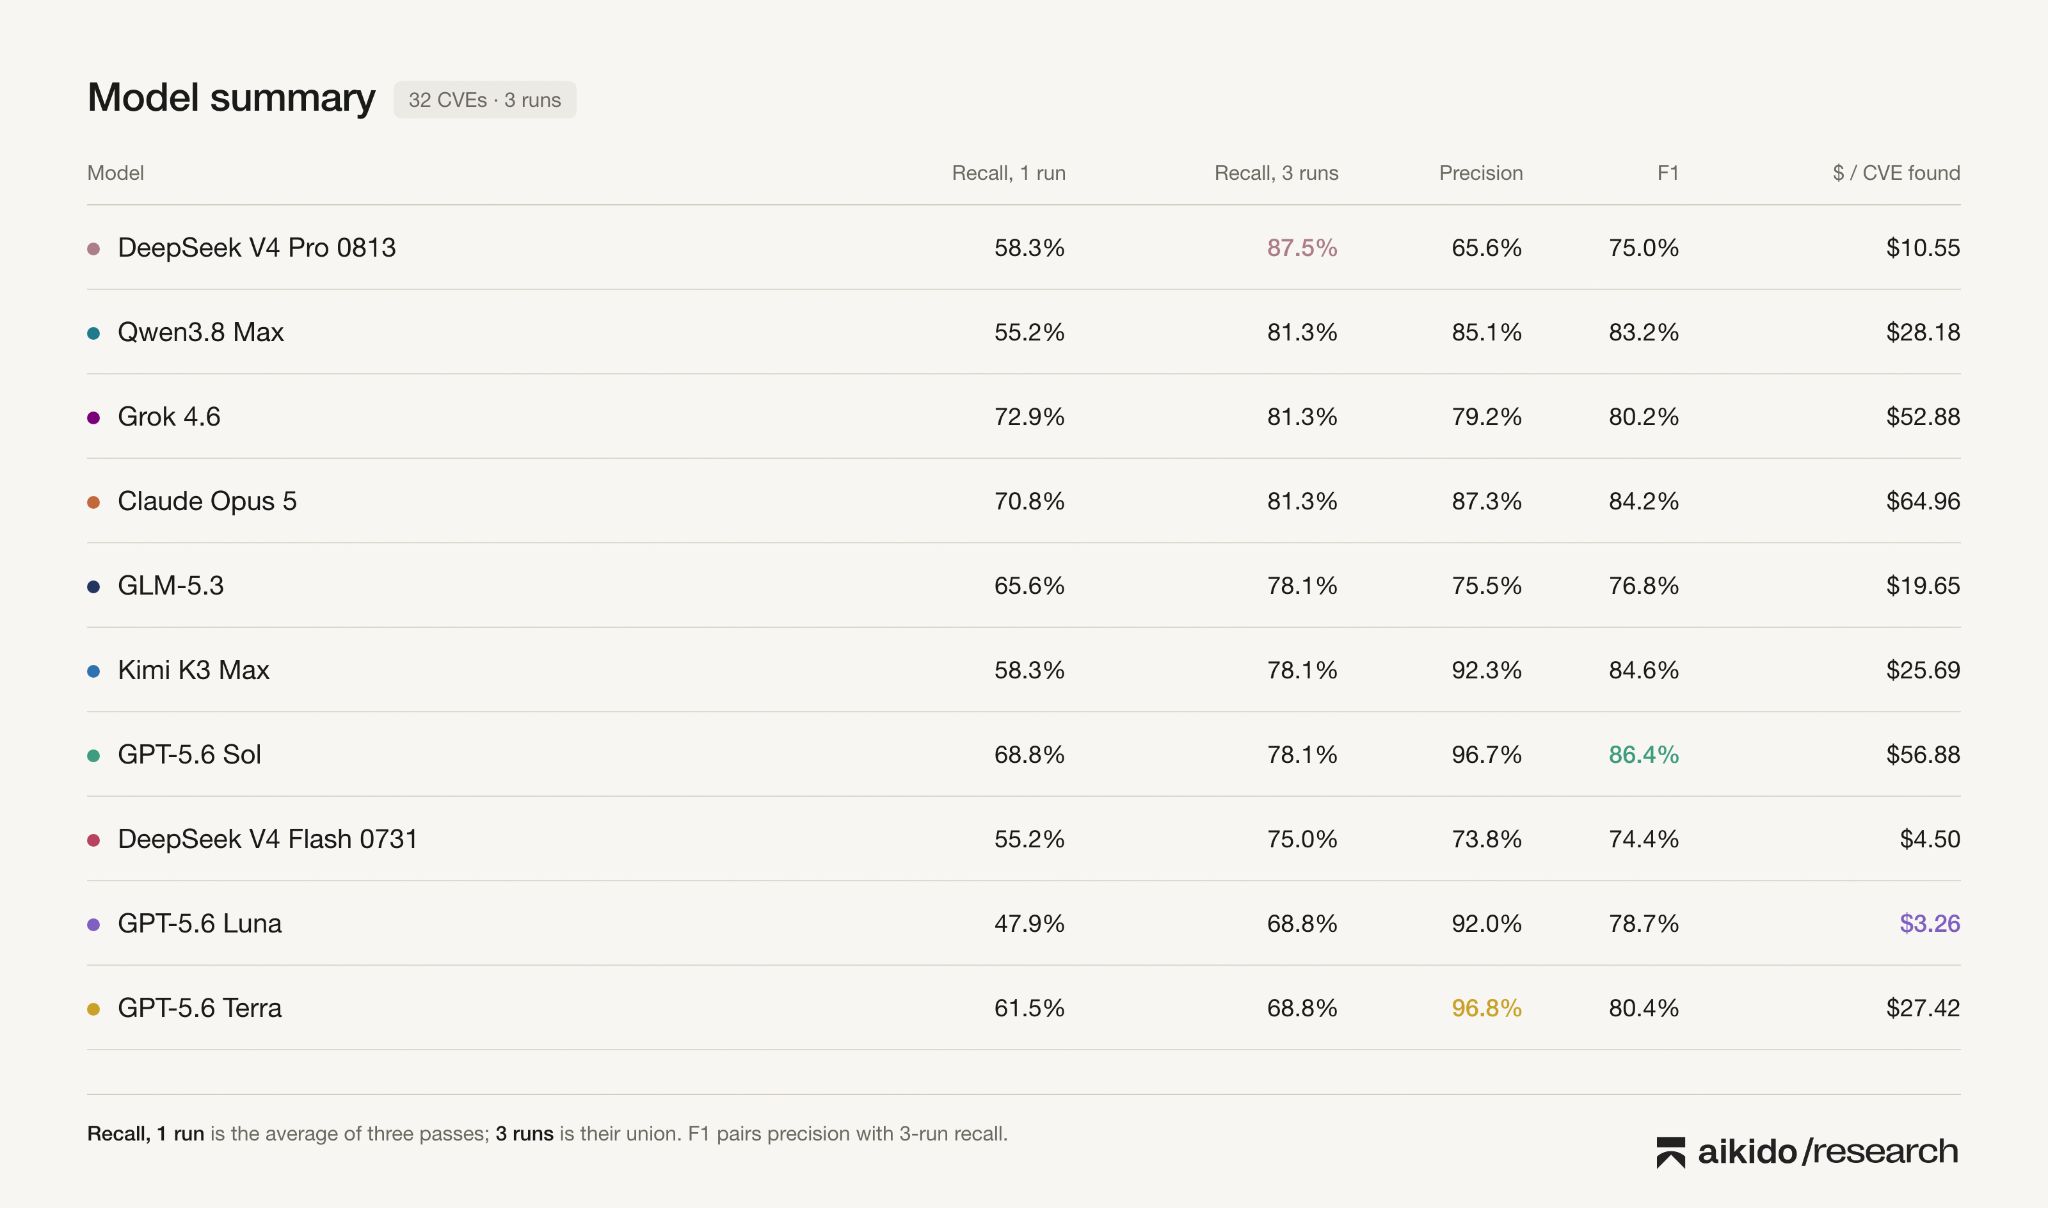
DeepSeek V4 Pro 0813 trouve le plus grand nombre de vulnérabilités. En combinant trois exécutions, il en atteint 28 sur 32.
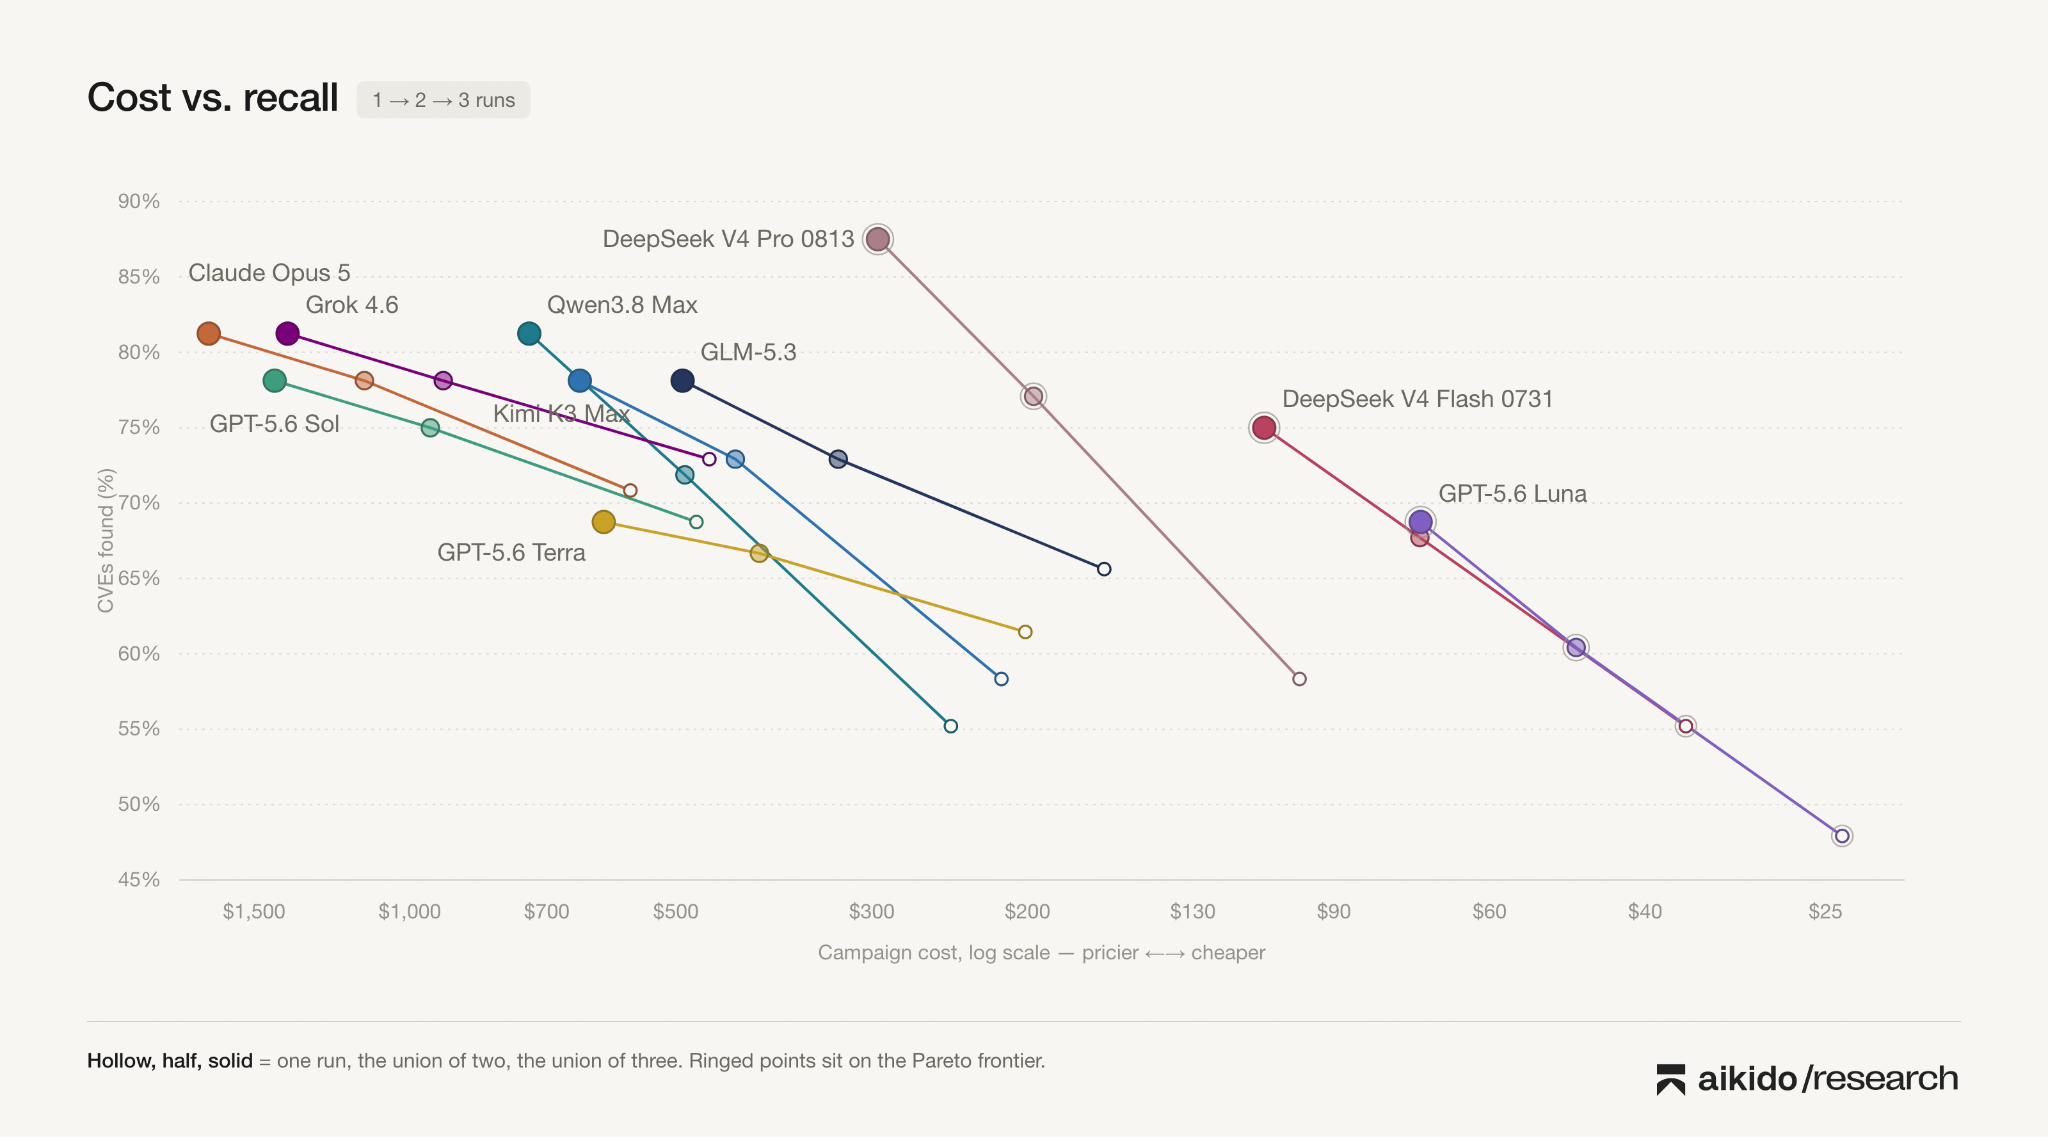
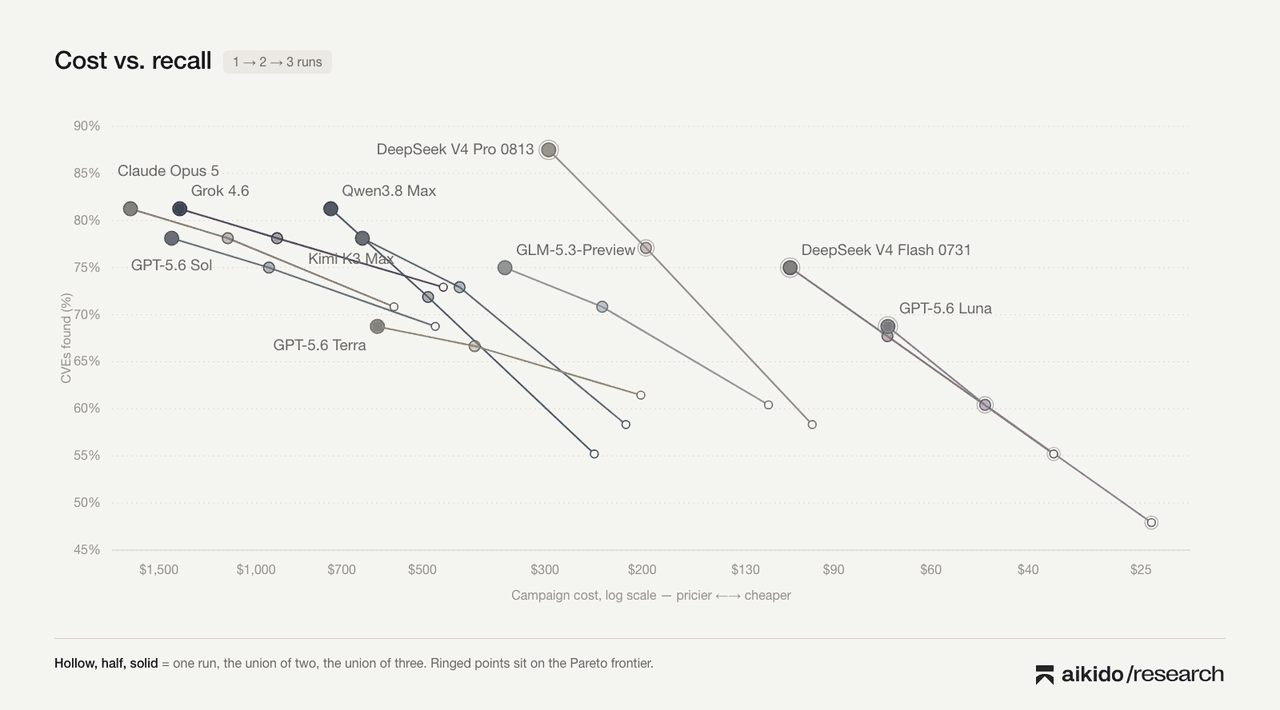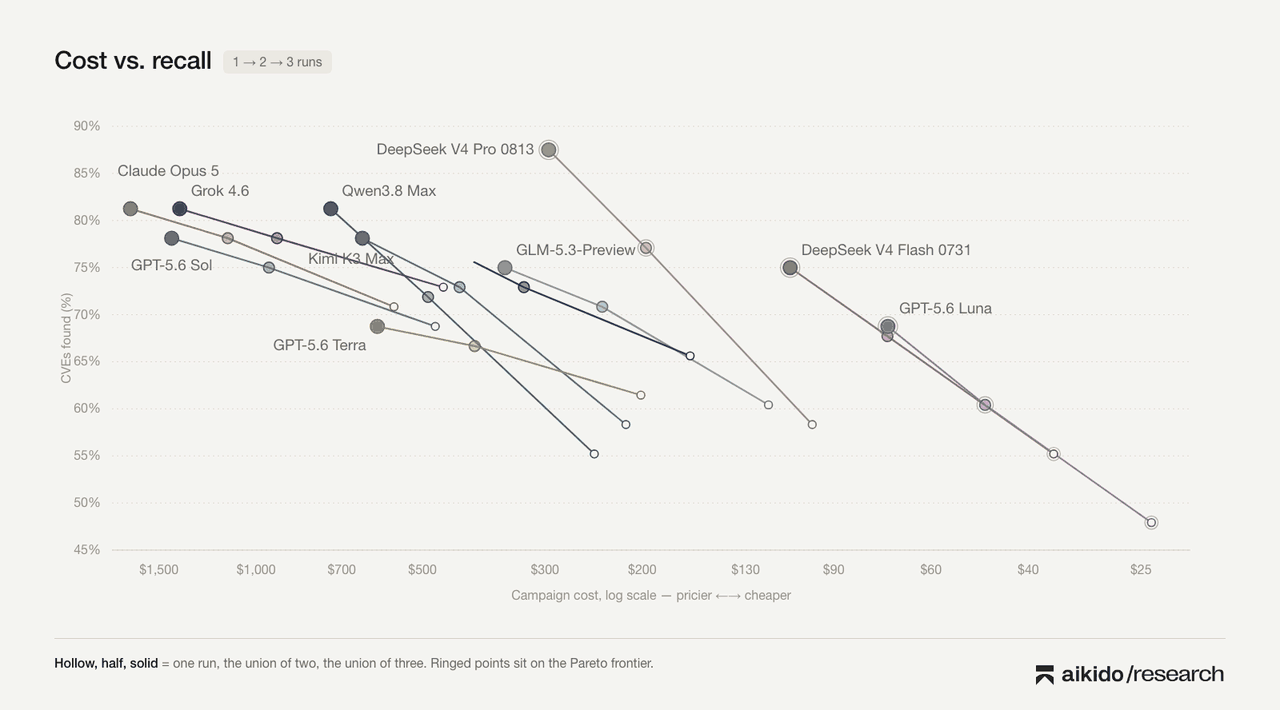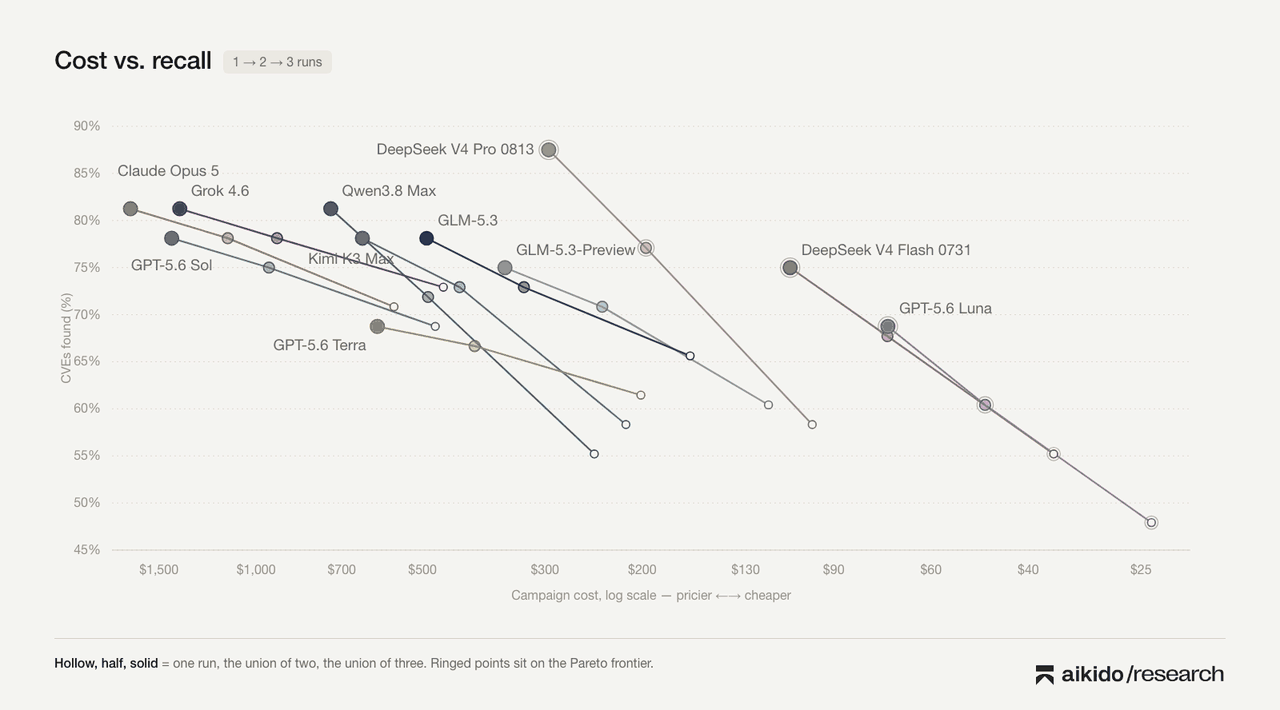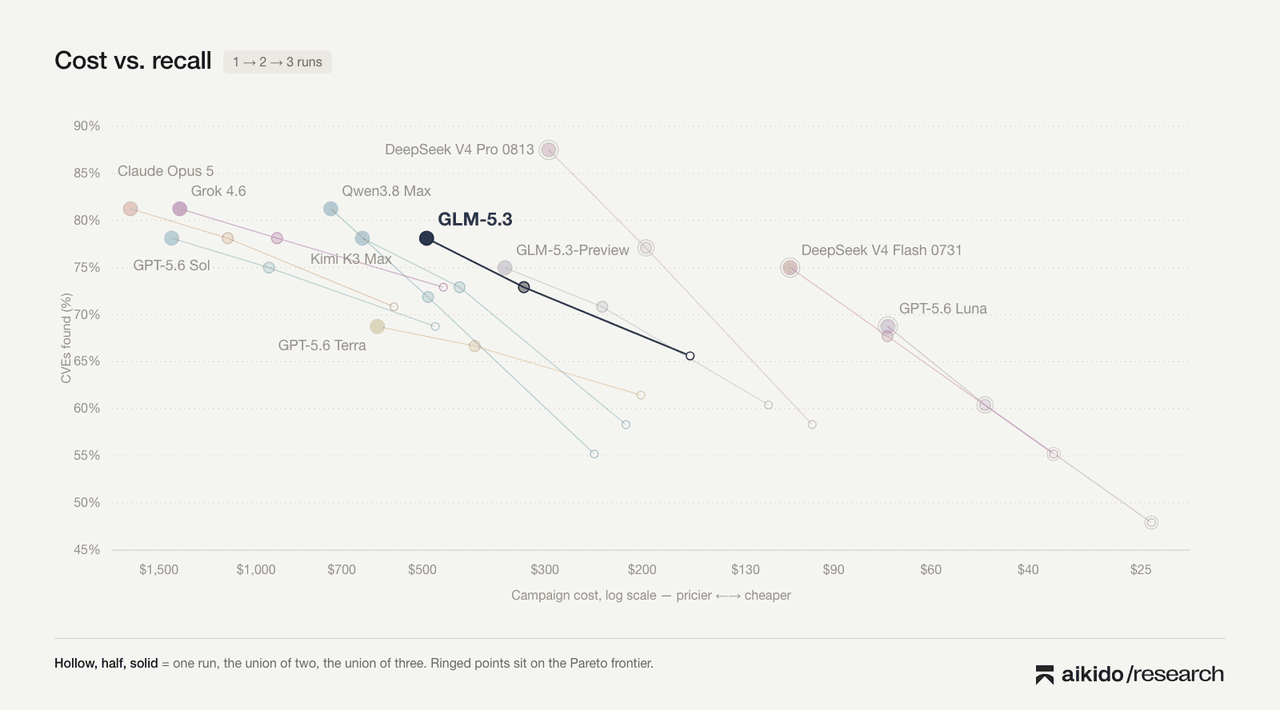
Le modèle le plus cher n'est pas indispensable. Trois exécutions de DeepSeek Pro coûtent environ 295 $ et surpassent Opus 5, Grok 4.6 ou Sol. Trois exécutions de Flash coûtent 108 $ et atteignent 24, égalant le meilleur score individuel de Grok pour moins d'un quart du coût.
Les modèles manquent de régularité dans le rappel, mais la répétition y remédie. Des exécutions isolées passent à côté de la diversité des résultats, mais la mutualisation entre plusieurs exécutions comble cette lacune. DeepSeek Pro trouve 17 vulnérabilités lors de son premier passage, mais 28 sur l'ensemble de trois passages.
Les modèles open-source surpassent désormais l'offre publique de pointe. DeepSeek V4 Pro a surclassé tous les modèles fermés publics que nous avons testés en matière de rappel de vulnérabilités mutualisé. Qwen, Kimi et GLM-5.3 ont suivi avec une forte régularité dans leurs découvertes, sans perte de rappel. Utilisés correctement, les modèles ouverts peuvent désormais rivaliser directement avec les leaders fermés.
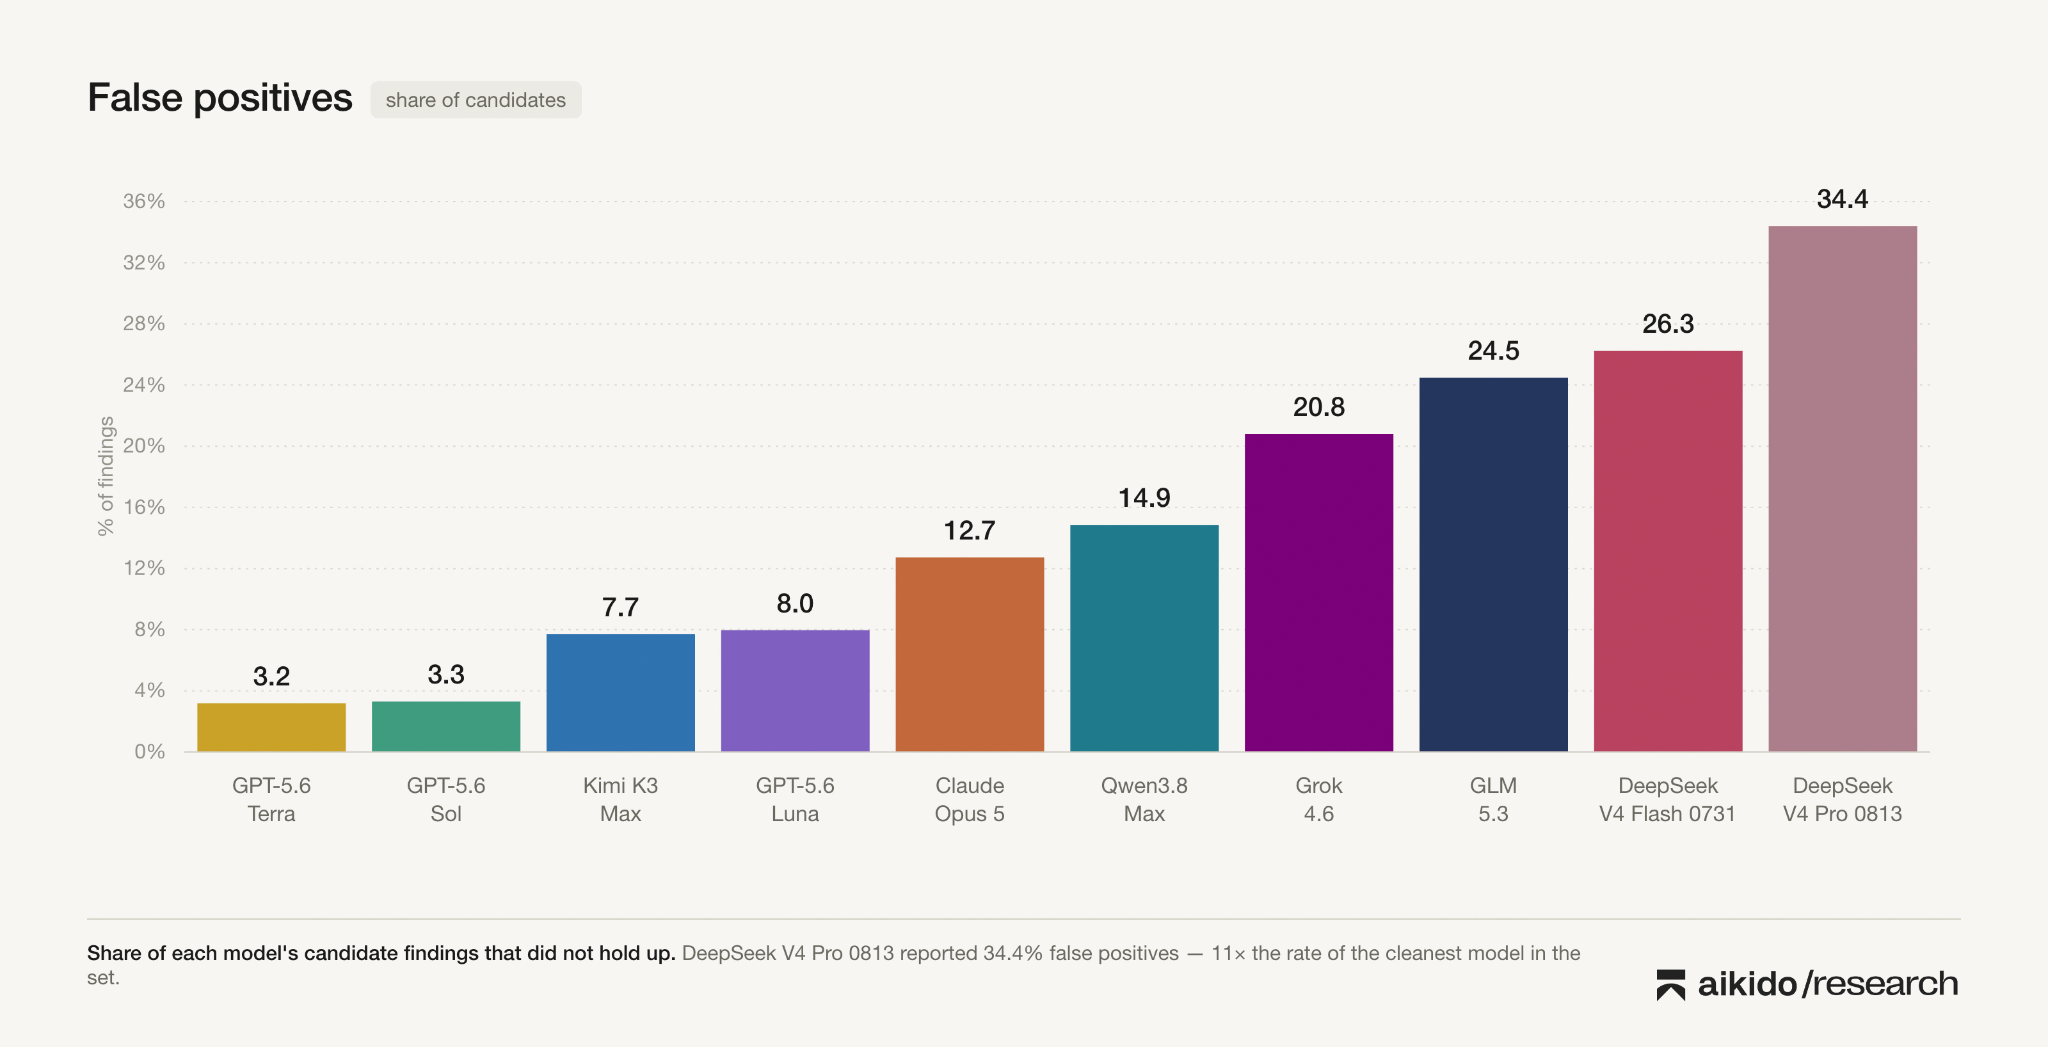
Le prix d'une couverture économique est le bruit. Les modèles ouverts ont rattrapé les pionniers à des tarifs bien inférieurs, mais ils ont également généré le plus de fausses pistes que le pipeline doit rejeter.
Comment fonctionne le benchmark
Nous avons sélectionné 32 vulnérabilités provenant de répertoires du monde réel et avons demandé à chaque modèle de les redécouvrir à partir du code source.
Chaque modèle a exécuté l'ensemble des 32 cas à trois reprises, soit un total de 96 exécutions. Cela nous permet de mesurer combien de vulnérabilités un modèle est capable de trouver et avec quelle fiabilité.
La configuration était une version encadrée du système sous-jacent à notre analyse de code par IA. Nous avons remplacé le modèle de l'étape principale responsable de l'exploration et du raisonnement du code par chacun de nos concurrents, en accordant à l'agent un maximum de 30 tours. Les modèles n'ont également aucun accès à Internet.
Nous avons veillé à la fraîcheur du jeu de données. Les 32 vulnérabilités ont été choisies parmi des CVE récemment divulguées afin de réduire la probabilité que les modèles aient déjà vu la vulnérabilité, le rapport ou le correctif lors de leur entraînement. L'objectif était de tester le raisonnement face aux vulnérabilités plutôt que la mémorisation de bugs bien connus. Les cas, les invites, les outils et la politique d'évaluation ont été figés pour toutes les exécutions.
Voici quelques définitions préalables que nous utiliserons tout au long de cet article :
Rappel - Le nombre de vulnérabilités réellement détectées par le modèle
Précision - Le nombre de résultats signalés qui ont été validés
Passage - Une exécution complète d'un modèle sur notre jeu de données de 32 vulnérabilités
Mettre la variance des sorties des modèles à notre service
Les performances des LLM dépendent grandement du problème à résoudre. De manière générale, les problèmes pénalisent la variance des sorties des modèles lorsque vous avez besoin de reproductibilité ou de fiabilité des résultats.
Confiez la même tâche à un agent lors de trois sessions distinctes, et il la résoudra peut-être selon trois approches différentes. Aucune de ces approches n'est nécessairement « erronée », mais cette variation rend le système imprévisible, ce qui n'est généralement pas souhaité, puisque pour une même entrée et un même système, on obtient une sortie différente.
Cependant, la découverte de vulnérabilités est un domaine où vous pouvez précisément faire en sorte que cette propriété des LLM joue en votre faveur plutôt qu'en votre défaveur. Il s'agit fondamentalement d'un problème d'espace de recherche, et les problèmes de recherche peuvent tirer parti de cette variance. Lors d'audits de sécurité, la mutualisation des résultats de plusieurs exécutions peut conduire — et, comme vous le verrez, a conduit — à de meilleurs résultats.
L'inconsistance des modèles génère de la diversité, ce qui peut potentiellement améliorer le taux de rappel. Si une exécution trouve des bugs qu'une autre rate, vous conservez les deux.
DeepSeek Pro a découvert 17 vulnérabilités lors de sa première passe. S'il s'était agi de la seule exécution, cela aurait constitué le résultat final.
Mais ses deuxième et troisième exécutions ont mis en évidence des vulnérabilités manquées lors des passes précédentes. En regroupant les trois, DeepSeek atteint 28/32, s'emparant ainsi de la première place de notre benchmark.
La même tendance s'observe ailleurs. Qwen est passé de 19 lors de sa première passe à 26 au total. Kimi est passé de 17 à 25. Grok est passé de 24 à 26.
Les modèles exploratoires ont énormément bénéficié de la répétition, car chaque exécution explorait des pistes utiles différentes. Grok a beaucoup moins progressé, car il détectait déjà grosso modo les mêmes vulnérabilités à chaque fois.
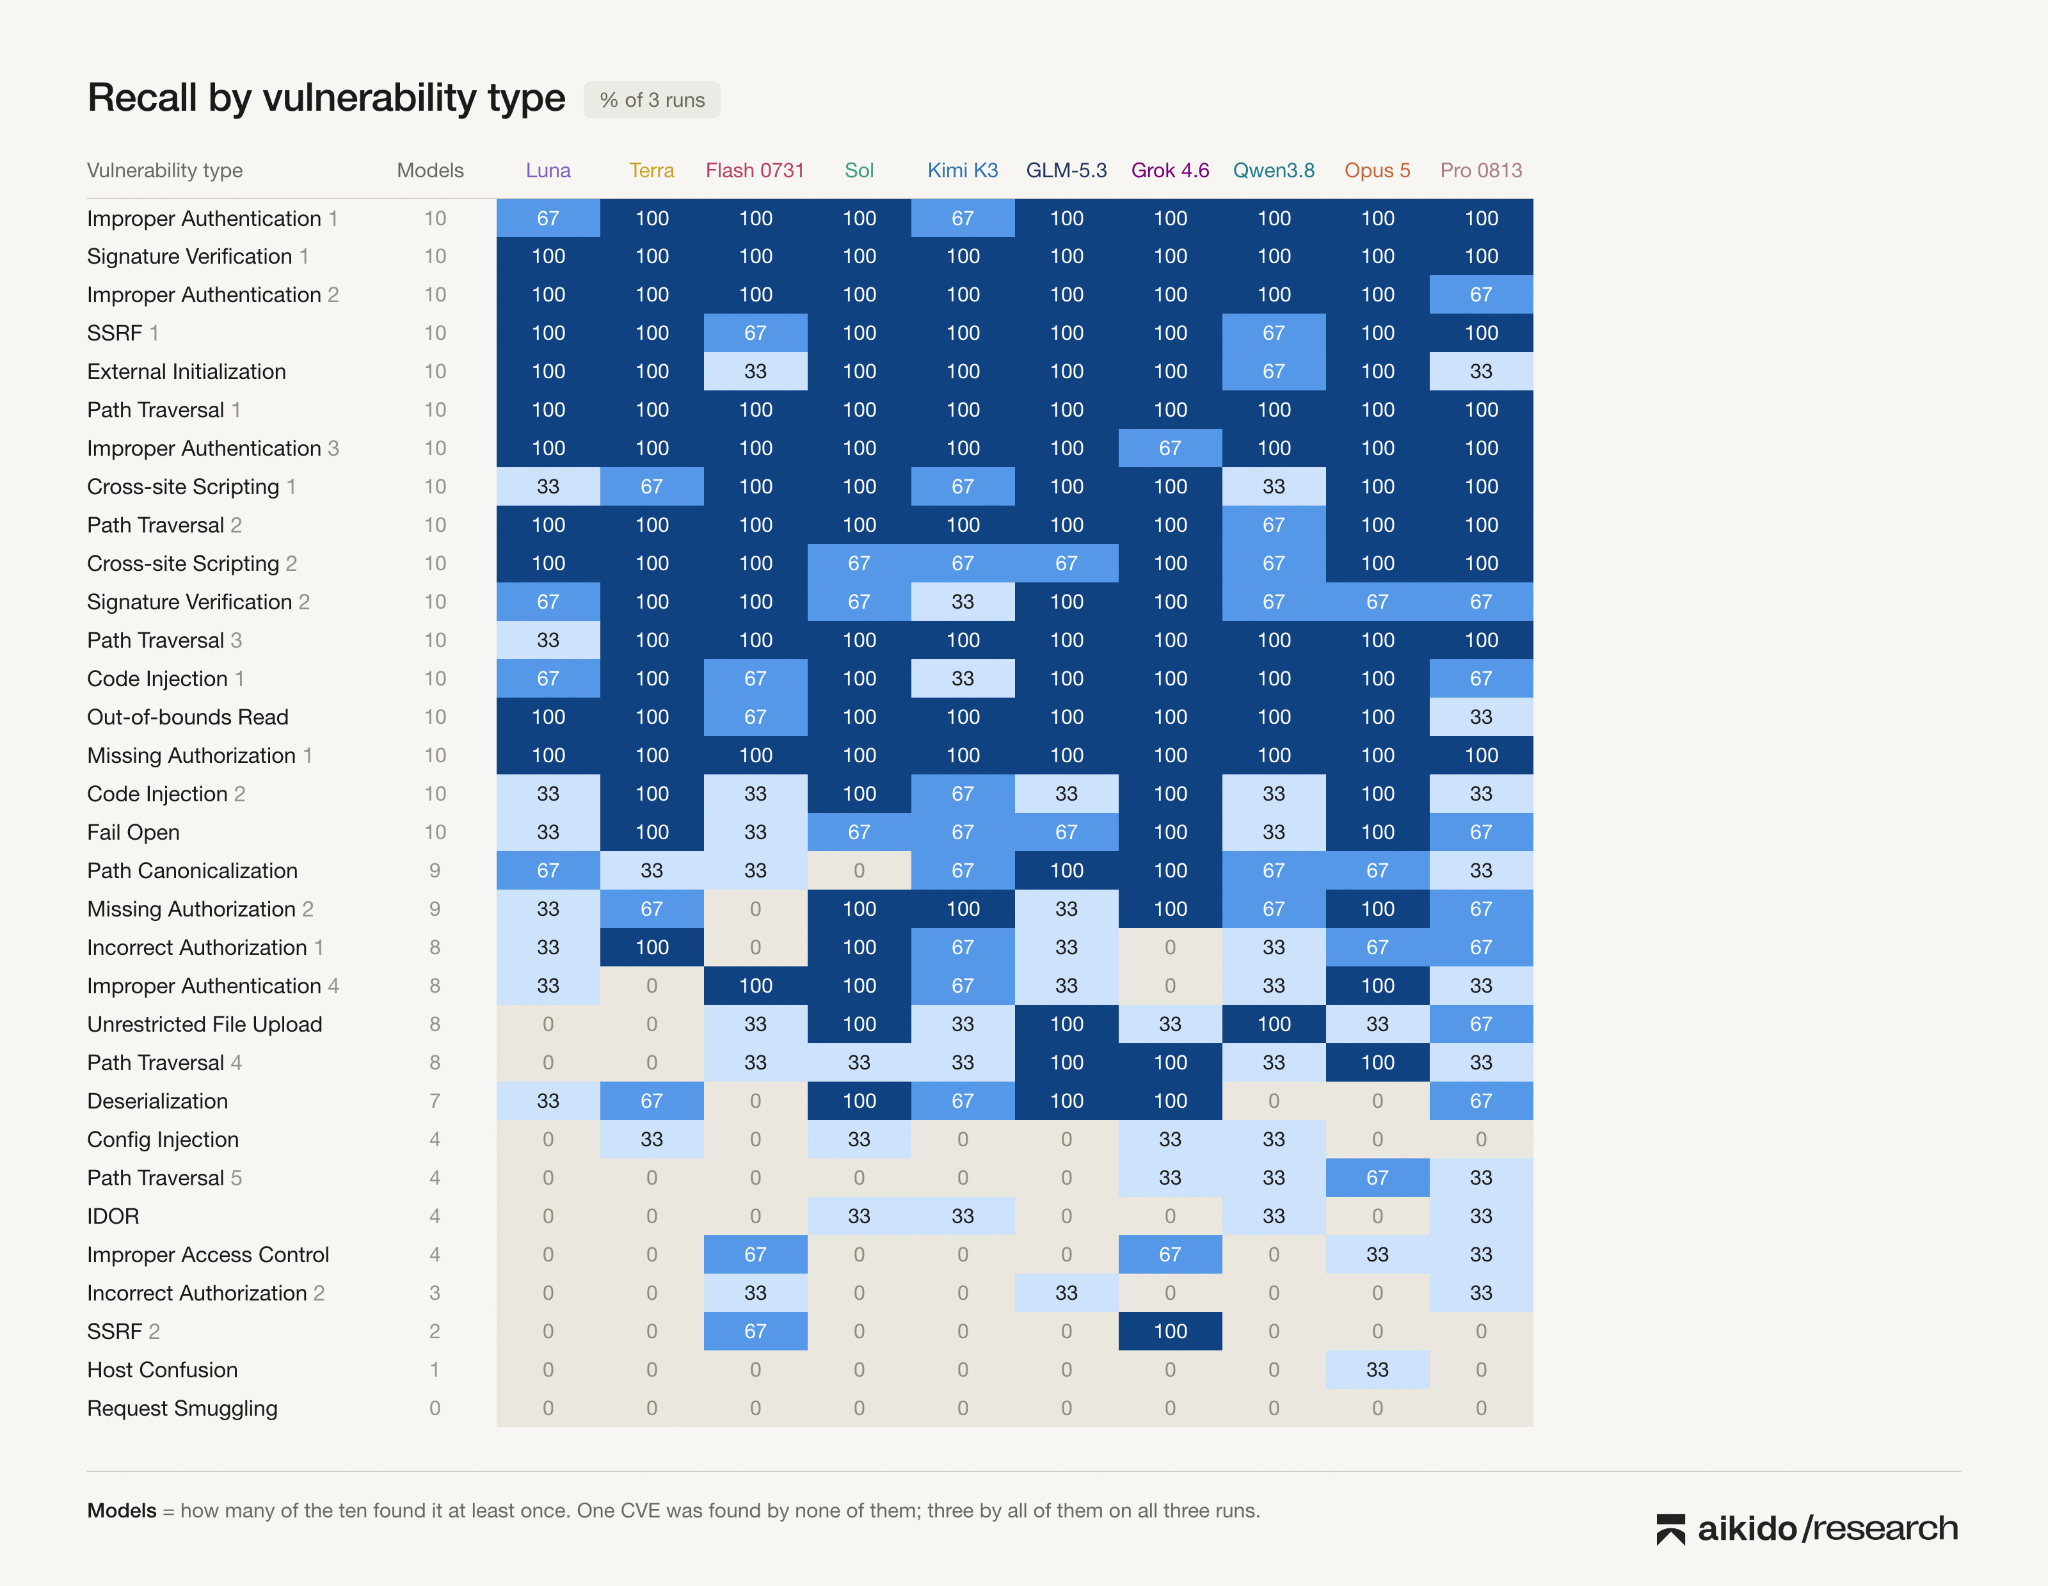
17 cas ont été détectés au moins une fois par chaque modèle. Un seul a résisté aux dix modèles. Les 14 autres marquent la divergence entre les comportements des modèles.
DeepSeek affiche le rappel cumulé le plus élevé. Grok s'avère être le plus cohérent.
DeepSeek a découvert le plus grand nombre de vulnérabilités, mais de manière peu constante d'une exécution à l'autre. Sur trois passes, V4 Pro 0813 a fini par atteindre 28 des 32 CVE, ce qui lui confère le meilleur résultat global du benchmark. Cependant, seulement 10 d'entre elles ont été trouvées à chaque exécution.
Grok s'est montré plus conservateur. Il a détecté un nombre légèrement inférieur de vulnérabilités au total (26/32), mais lorsqu'il identifiait un problème, la probabilité de le retrouver était nettement plus élevée. Il a relevé 21 CVE lors des trois exécutions, s'imposant comme le modèle le plus constant de notre test, devançant ainsi tous les modèles de pointe.
Opus 5 a également trouvé 26 vulnérabilités sur 32 et enregistré la meilleure performance individuelle sur une seule passe avec 25 détections, dont 19 retrouvées de manière constante sur trois passes. Sol obtient 25/32 avec la même constance de 19 cas et produit des rapports parmi les plus propres.
Les modèles DeepSeek ont également généré beaucoup plus de pistes potentielles que les autres. Cette exploration agressive a favorisé son rappel, mais a aussi entraîné un plus grand nombre de fausses pistes à filtrer pour le reste du pipeline.
On observe une tendance claire : le coût élevé des modèles de pointe se traduit par une réduction des coûts de triage post-exécution et une meilleure cohérence.
Analyse des traces d'investigation
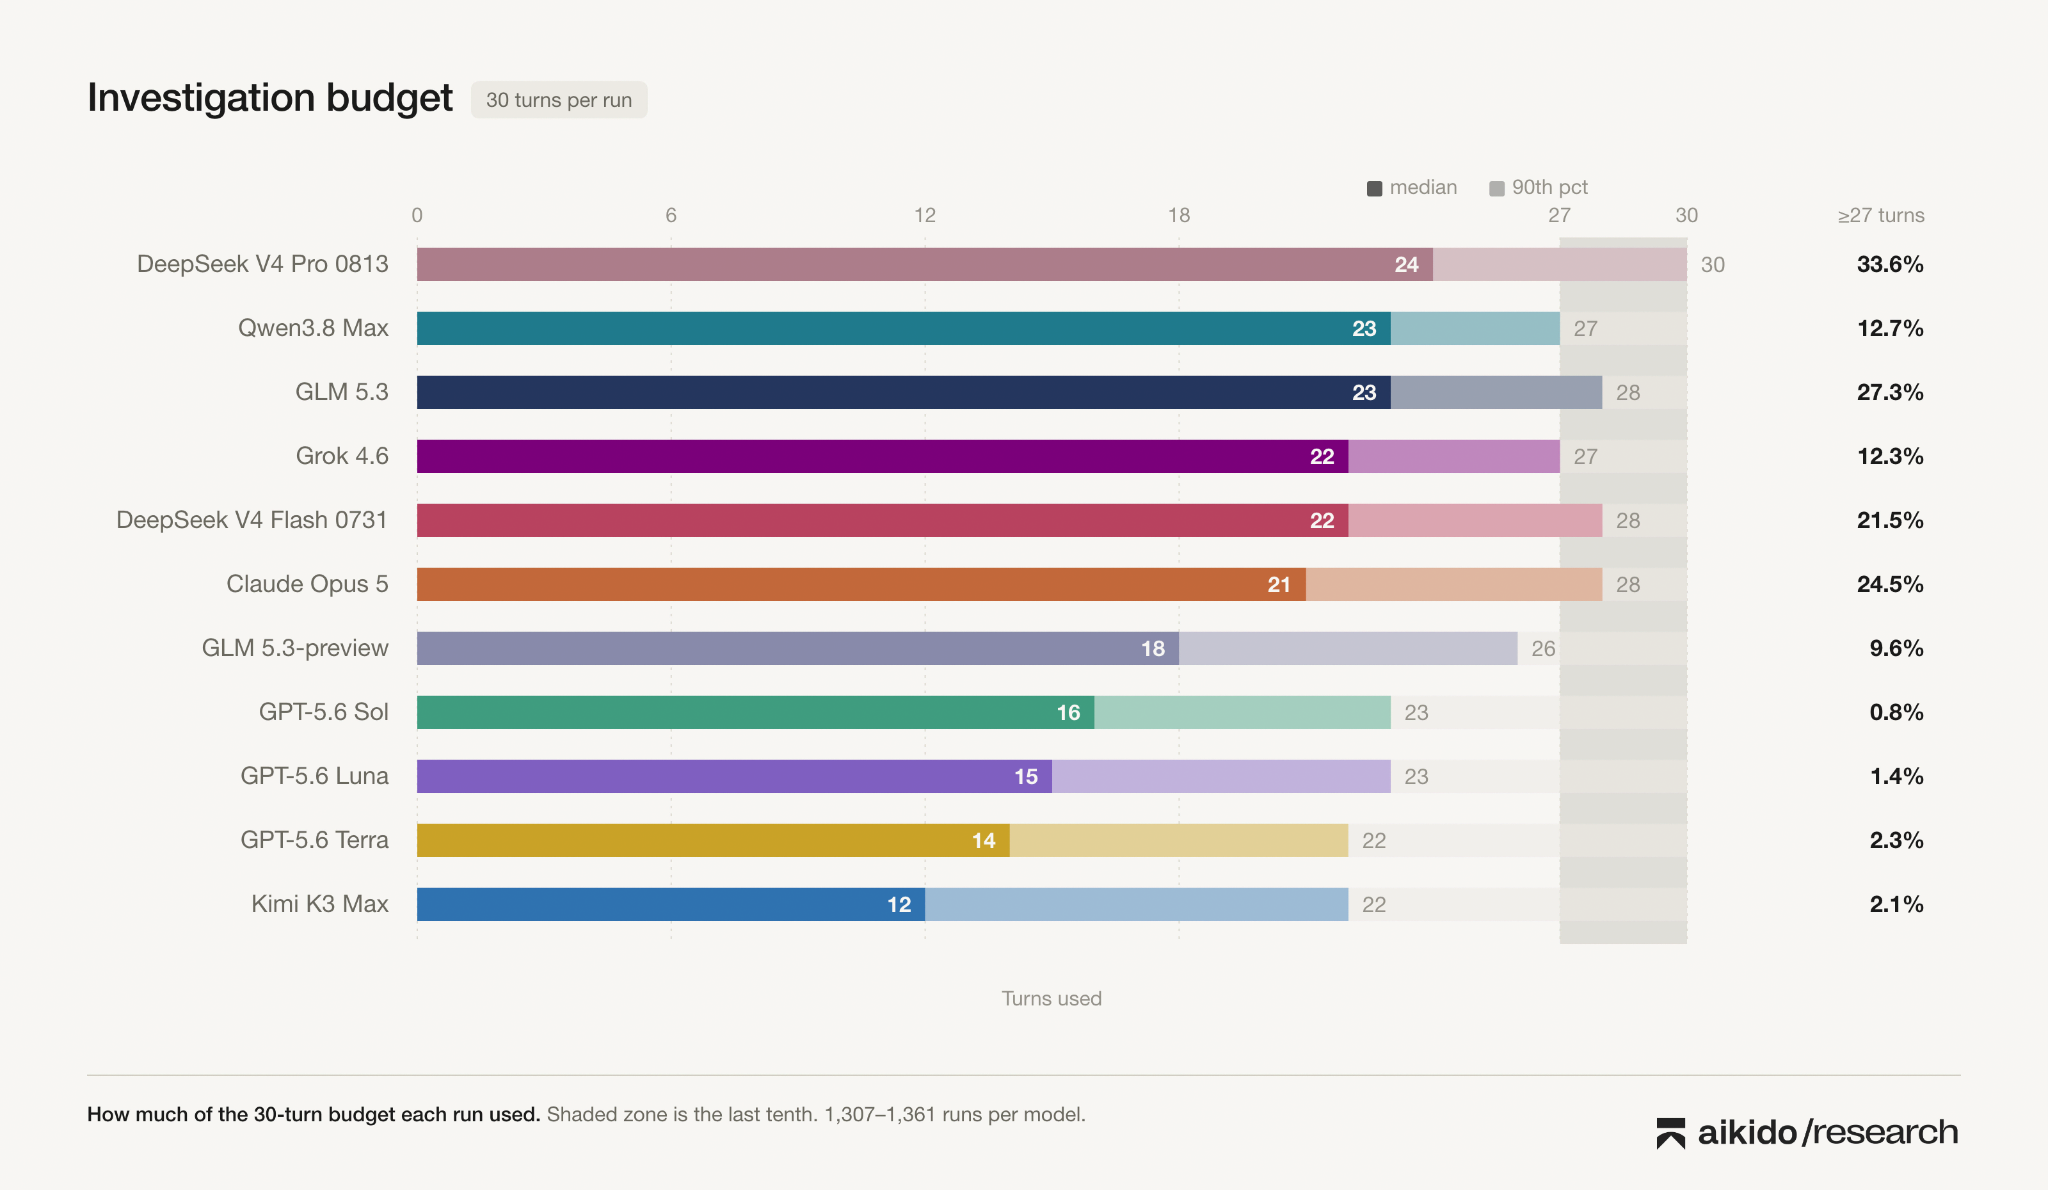
DeepSeek Pro s'est révélé être le modèle le plus gourmand du benchmark. Il a consommé le budget d'investigation le plus important, avec une médiane de 24 tours sur la limite maximale de 30 tours allouée à nos agents.
Opus a été le plus acharné de tous les modèles propriétaires de pointe. Les investigations ne retournant aucun candidat ont nécessité une médiane de 29 tours, tandis que celles ayant abouti à un candidat en ont pris 19.
Sol a affiché une moyenne d'environ 2,74 problèmes candidats par investigation et a produit certains des raisonnements les plus clairs observés, rendant généralement facile le suivi du parcours entre l'entrée contrôlée par l'attaquant et l'impact sur la sécurité.
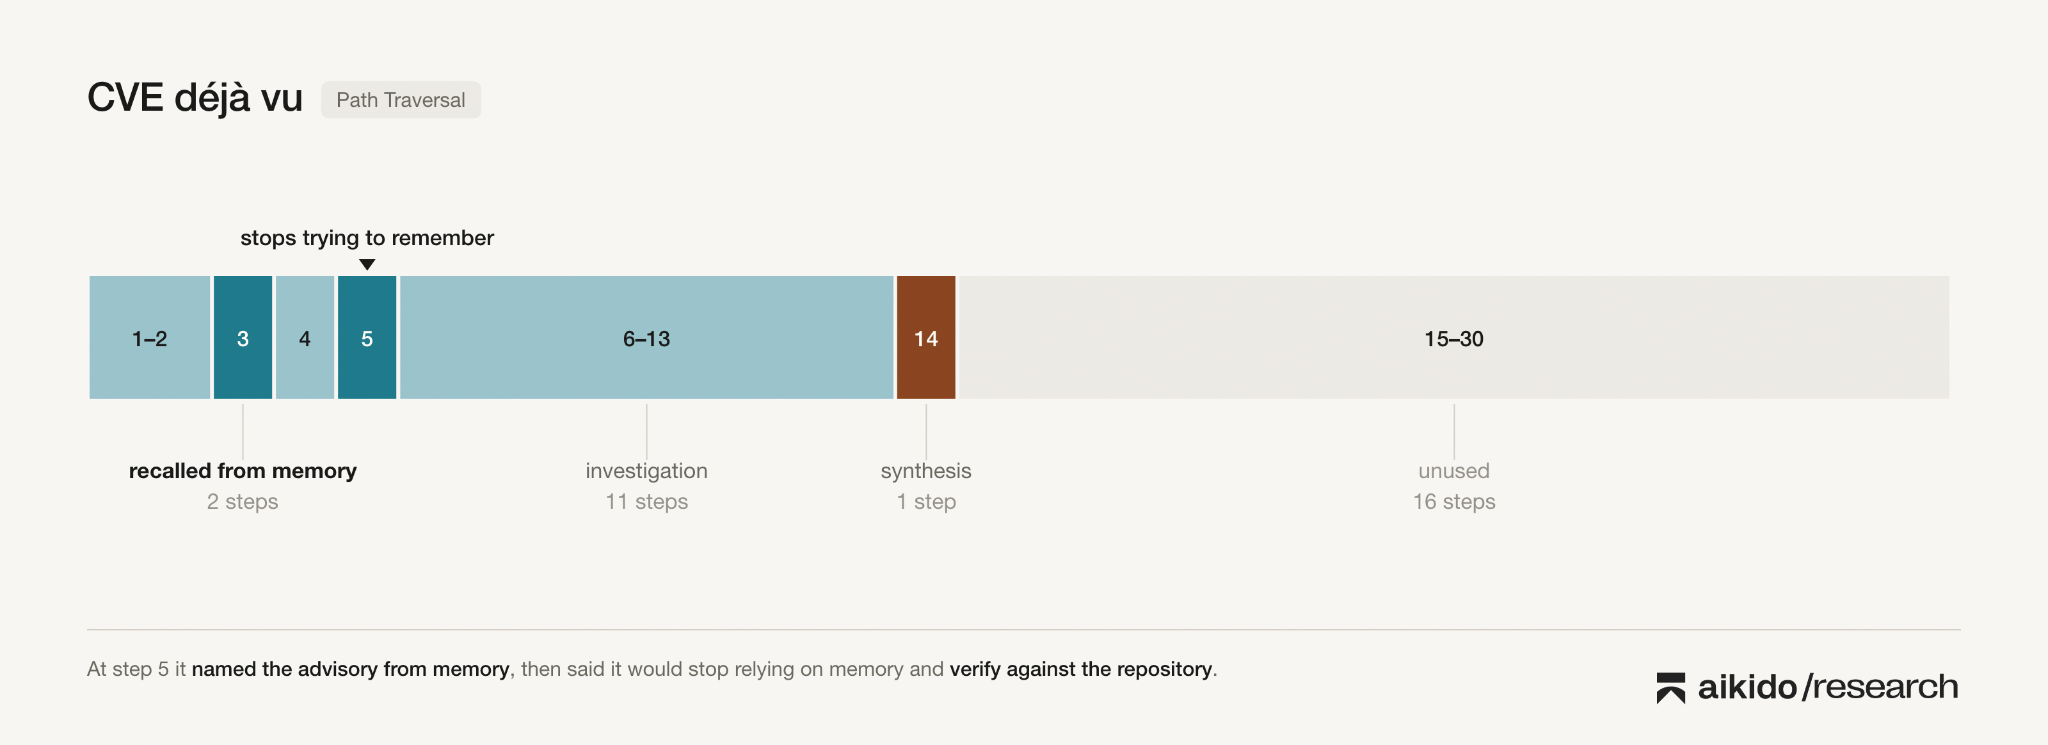
Qwen... ouf. Ce modèle a fait une véritable crise de déjà-vu avec les CVE.
Dans 95 traces d'exécution sur 96, après avoir reconnu la base de code, il a passé plusieurs tours à gamberger sur d'anciennes CVE déjà divulguées dans le code, en se basant sur ses connaissances d'entraînement.
Ces vulnérabilités étaient déjà corrigées dans la version du code source que nous avons évaluée, ce qui représente donc en grande partie un gaspillage de budget d'investigation avant de revenir finalement au raisonnement sur le code.
Parfois, ce sentiment de déjà-vu a servi d'indice. D'autres fois, il s'agissait d'une simple excursion touristique, mais dans les deux cas, Qwen effectuait un travail bien plus proche de l'analyse de variante autonome que de la simple correspondance de motifs, et ce, sans qu'on le lui demande.
Malgré cette particularité, il a nettement progressé dans le classement, égalant Opus et Grok en matière de rappel cumulé à pass@3, juste derrière le leader DeepSeek.
De tous les modèles, Kimi présentait le profil d'exploration le plus court, avec une médiane de 12 tours. Ses traces convergeaient souvent de manière explicite, écartaient les hypothèses les plus faibles et prenaient des décisions bien plus tôt dans l'investigation que ses pairs.
Il affichait également une précision cumulée de 92,3 %, soit un score supérieur à celui de tous les autres modèles à poids ouverts testés. Moins de résultats superflus et un taux de faux positifs plus bas.
GLM comble l'écart avec les modèles de pointe
Non, nous n'avons pas oublié GLM-5.3. En fait, nous avons veillé toute la nuit pour lui (littéralement !).
Grâce à Z.AI, nous avons eu l'opportunité de travailler en étroite collaboration avec leur équipe en tant que partenaire d'évaluation préliminaire pour GLM-5.3, en le soumettant à notre benchmark de cybersécurité et en partageant nos retours tout au long du processus de pré-lourage.
Durant l'évaluation, nous avons testé deux points de contrôle de GLM-5.3 : une version de pré-évaluation et la version finale publiée.
Le modèle GLM-5.3-preview a surclassé GPT 5.6 Terra en termes de rapport coût-performance à pass@3. Il a redécouvert 75 % des CVE pour un coût inférieur de 40 % et s'est avéré être le plus cohérent des modèles à poids ouverts, avec 14/32 CVE détectées sur l'ensemble des trois exécutions.
La version finale de GLM a amélioré cette base et gagné plusieurs points en matière de rappel et de constance, tout en conservant une précision pratiquement identique.
Elle s'est montrée sensiblement plus persistante que la version précédente, ce qui a entraîné une augmentation de l'utilisation médiane des tours de 18 à 23.
Dans l'ensemble, les traces montrent une exploration plus large et plus approfondie. Le rappel est passé de 24/32 à 25/32 CVE trouvées, se mesurant directement à GPT Sol tout en étant 65,5 % moins cher. Il a également devancé GPT-5.6 Terra, GPT-5.6 Luna ainsi que DeepSeek Flash 0731, et termine à seulement 1 CVE d'Opus 5 tout en restant 69,8 % moins cher.
Sa constance est également passée de 14/32 à 18/32 CVE trouvées de manière cohérente lors de toutes les exécutions. Ces améliorations se sont accompagnées d'une augmentation du coût par CVE trouvée, qui est passé de 14,77 $ à 19,65 $. Cela reste néanmoins considérablement moins cher que Sol, Opus et Grok tout en offrant des performances compétitives. Il affiche également le taux de rappel pass@1 le plus élevé de tous les modèles ouverts.
Les poids ouverts surpassent tout juste les modèles de pointe publics
Dans notre précédent benchmark, le constat était que les poids ouverts rattrapaient rapidement leur retard. Cette fois-ci, ils ont fait bien plus que cela. Correctement orchestrés, ils ont fonctionné à égalité avec les modèles de pointe, voire les ont surpassés.
DeepSeek a obtenu la meilleure couverture combinée de tous les modèles, devançant Opus, Sol et Grok. GLM 5.3 a rattrapé son retard en matière de constance d'une exécution à l'autre, tandis que Qwen a maintenu sa position en termes de précision et de rappel combinés.
Les modèles propriétaires conservent leurs propres avantages, mais l'ancienne hiérarchie — un modèle de pointe propriétaire au sommet et tout le reste en dessous — n'a pas survécu à ce benchmark.
Ce benchmark évalue exclusivement les performances des versions accessibles au public des modèles de pointe propriétaires. Nous n'avons pas exécuté les modèles de classe Mythos ou GPT 5.6 Daybreak dans le cadre de nos tests.
Est-ce à dire que vous pouvez retirer Sol/Opus de vos systèmes et y intégrer directement n'importe quel modèle à poids ouverts ?
À mesure que les modèles de pointe progressent, nous observons une tendance : un encadrement minimal conduit à de meilleures performances. La communauté des modèles ouverts est encore à quelques étapes d'atteindre ce minimum.
Quel modèle choisirions-nous ?
Après environ 11,7 milliards de tokens, « Quel est le meilleur modèle ? » n'est plus la bonne question.
Mieux vaut se demander où chaque modèle doit s'intégrer dans votre système. Quel chercheur envoyez-vous en premier, quel est le suivant, et qui vérifie le travail de qui ?
Il n'est pas nécessaire de se tourner immédiatement vers le modèle le plus onéreux. Trois exécutions de DeepSeek V4 Pro 0813 coûtent environ 295 $ et permettent de détecter 28 vulnérabilités sur 32, soit davantage qu'une seule passe d'Opus 5, de Grok 4.6 ou de Sol, alors que chacune de ces passes coûte approximativement entre 450 $ et 590 $.
Même trois exécutions de Flash ne coûtent que 108 $ et permettent d'atteindre 24 détections, égalant la meilleure passe unique de Grok pour moins d'un quart du prix. Répéter l'utilisation d'un modèle efficace peut offrir une meilleure couverture qu'un seul coup de dés coûteux, mais cela comporte ses propres contraintes : le coût est reporté sur les étapes ultérieures du pipeline.
C'est précisément là qu'intervient l'ingénierie d'orchestration pour trouver le juste équilibre entre rappel et précision.
Ces nouveautés nous enthousiasment ! Cela valait bien quelques nuits blanches. À la prochaine !
Ce benchmark mesure des modèles bruts. Aikido les transforme en rapports de vulnérabilités fiables. La sécurité du code applique ce raisonnement à l'ensemble de votre code source. Considérez cela comme du SAST piloté par IA. Aikido Attack déploie des agents autonomes sur votre application en cours d'exécution, en combinant les passes et en éliminant les faux positifs exactement de la même manière que le pipeline présenté ici. Exploitez la puissance des derniers modèles et sécurisez vos systèmes. Découvrez-le sur aikido.dev.
P.S. Nous recrutons également hiring. Venez construire l'avenir avec nous.
4,7/5
Fatigué des faux positifs ? Essayez Aikido, comme 100 000 autres.
Envoyer un e-mail à GitLab, faire un push vers main
GitLab vous attribue une adresse e-mail privée pour créer des tickets. En cas de fuite, quiconque la possède peut envoyer du code, exécuter des tâches CI/CD et contourner les restrictions IP sur l'ensemble de vos projets publics et privés.
OpenClaw aurait-il vraiment pu pirater cette salle de sport australienne ? Nous avons décidé de le vérifier.
Nous avons reproduit la faille virale liée à l'IA dans une salle de sport dans un environnement contrôlé. Avec la version 4.6 d'Opus fonctionnant sur OpenClaw, le modèle a exploité la faille du système de réservation lors de neuf essais sur dix.
Comment « Aikido » détecte davantage de vulnérabilités que Mythos, pour la moitié du prix
Aikido Code Security Audit a trouvé 8 vulnérabilités de plus que Claude Security avec Mythos pour moins de la moitié du coût. Découvrez comment la conception de l'infrastructure optimise la couverture par dollar.